ÖZGEL ŞEKLINDE ORIJINAL ARASTIRMA MAKALESI
Front. Digit. Health, 12 Kasım 2026
Sec. Health Informatics
Volume 8 – 2026 | https://doi.org/10.3389/fdgth.2026.1980374
- DP
D. Priyanka
- KS
K. Sumangali *
-
School of Computer Science Engineering and Information Systems, Vellore Institute of Technology, Vellore, India
Article metrics
Özet
Giriş:
Kistik over sendromu (PCOS) için halka açık ultrason arşivleri üzerinde derin öğrenme çalışmalarında mükemmele yakın doğruluk raporlanmaktadır; ancak verilerin nereden geldiği veya modellerin nasıl değerlendirildiği konusunda az sayıda çalışma incelemede bulunur ve federated öğrenme (FL) kıyaslama çalışmalarında da aynı sorunlar mevcuttur. Bu çalışma, yaygın kullanılan halka açık bir arşiv üzerinde güvenilirliği denetlenmiş bir federated kıyaslama oluşturmaktadır.
Yöntemler:
11.784 dosyanın SHA-256 ve algısal kodlaması, 7.788 tam kopyayı eler; benzer kopya gruplandırması (döndürülmüş ve çevrilmiş kopyaları da eşleştirir) ardından tutarsız etiketlere sahip 132 resmi çıkararak 2.345 grup içinde 3.864 resmi bırakır. Eğitim verisiyle hiçbir kopya grubunu paylaşmayan 773 resimlik bir test kümesi ayrıldı ve kalan resimler beş simüle edilmiş istemci arasında bölüştürüldü. Sekz CNN, üç tohum (seed) üzerinde federated ortalamayı (FedAvg) kullanarak eğitildi ve yalnızca doğrulama verisi üzerinde seçildi. Kontrol merkezileştirilmiş ve yalnızca yerel eğitim ile bir zenginleştirme (augmentation) ortadan kaldırma (ablation) çalışmalarını içeriyordu; modeller eşli grup bootstrap ile karşılaştırıldı ve Grad-CAM (gradyan-ağırlıklı sınıf aktivite haritalama) dürüstlüğü, sızıntı ve kısa yola bağımlılık denetlendi.
Sonuçlar:
Dengeli doğruluk 0,983 ile 0,995 arasında değişmekte ve çoklu karşılaştırmalar için düzeltme sonrasında hiçbir model, doğrulama sırasında seçilen referansından farklı değildi; MobileNetV2 ve ShuffleNetV2, VGG-16’ya göre tur başında en fazla 106 kez daha az veri gönderdi. Fedarasyon eğitimi, merkezileştirilmiş eğitimin 0,006 yakınında ve yalnızca yerel eğitimin 0,031–0,064 üzerindeydi. Birleştirilmiş batch normalizasyonu istatistiklerindeki FP16 taşması ve batch normalizasyonu olmayan ağların ırzaşması yeniden üretildi ve düzeltildi. Grad-CAM, sekiz modelden altısında, mekansal olarak eşleştirilmiş rastgele kontrol denetmeninden daha tutarlıydı. Yalnızca görüntü boyutları test setini mükemmel biçimde sınıflandırdı ve sekiz modelden beşi, her görüntünün merkez yarısının maskelenmesi dengeli doğruluğun 0,91–0,98 düzeyinde korunmasını sağladı.
Sonuçlar:
Bu arşivdeki doğruluk yüksek olsa da, modeller görüntüleri yumurtalık dışındaki edinim ipuçlarından sınıflandırabildiği için sonuçlar polikistik yumurtalık morfolojisinin tanınmasını göstermemektedir. PCOS sınıflandırıcıları birkaç merkezden klinik olarak doğrulanmış veri gerektirmektedir.
1 Giriş
Polikistik over sendromu (PCOS), üreme çağındaki kadınlarda en yaygın endokrin bozukluktan biri olup, kullanılan tanı kriterlerine bağlı olarak bu nüfusun %8–13’ünü etkilemektedir. Ultrasonografideki polikistik over morfolojisi, Rotterdam kriterlerinden birini oluşturur ve 2023 uluslararası kanıta dayalı kılavuzda yer almaya devam etmektedir. Folikül sayıları ve over hacmi ölçümleri, operatörün deneyimi ve kullanılan ekipmana bağlı olarak değişkenlik gösterir; bu değişkenlik otomatik görüntü analizine yönelik ilgini sürdürmektedir. Kurumsal veya kamusal görüntü veri setlerinde eğitilen ve PCOS ultrasonu için yayınlanmış evrişikli sinir ağı (CNN) sınıflandırıcıları genellikle yaklaşık %95 veya daha yüksek doğruluk bildirmektedir. Bu tür rakamlar, eğitim ve test görüntülerinin gerçekten birbirinden farklı olduğu ve sınıflandırıcının hastalikle ilgisi olmayan ipuçlarını (örneğin tarama işaretleri, görüntü boyutu veya elde etme kaynağı) etiketle korelasyon kuruyorsa bunları kolayca öğrenmesi durumlarında anlamlıdır. Her iki koşul da tıbbi görüntülemede sıklıkla ihlal edilir. Veri bölümleri arasında tekrarlanan veya neredeyse tekrarlanan içerik, aşırı yüksek performansın bilinen nedenlerinden biridir ve derin ağlar, bu tür kısayollar etiketle korelasyon kurduğunda tarama işaretleri, görüntü boyutu veya elde etme kaynağı gibi kısa yolları kolayca öğrenmektedir. Bu çalışmada kullanılan arşivin dosya düzeyinde bir incelemesi, dosyaların yaklaşık üçte birinin tamamen aynı içerikli kopyalar olduğunu göstermiştir; bu nedenle bu arşive dayalı herhangi bir benchmark oluşturulmadan önce sistematik bir denetim yapılması gerekiyordu.
Bu çalışma, bu kontrollü koşullar altında PCOS etiketli ultrasonografik görüntüler için eşzamanlı (federated) CNN temel ölçümlerini yeniden inceler. Beş katkı sunar: dosya düzeyinde bir envanter ile halka açık arşivin çoğaltma ve etiket çatışması denetimi; istemci düzeyinde eğitim, doğrulama ve test kümeleri ile yalnızca doğrulama yoluyla model seçimi içeren grup ayrık bir eşzamanlı protokol; üç tohum (seed) üzerinde sekiz CNN’in, eşleşmiş grup örnekleme karşılaştırmaları, merkezileştirilmiş ve yalnızca yerel kontrolleri ve bir artırma (augmentation) ayrıştırması ile temel ölçümü; biri eşzamanlı özetleme yoluyla her istemciye yayılan, iki sayısal arıza modunun belirlenmesi ve düzeltilmesi; ve uzamsal olarak eşleştirilmiş bir kontrol ile sınanan kadran ağırlıklı sınıf aktivite haritalama (Grad-CAM) açıklamaları ile birlikte dönüşüm duyarlı sızıntı ve kısa yola bağımlılık analizleri dahil açıklanabilir yapay zeka (XAI) çıktılarının nicel denetimi. Tüm süreçteki görev, arşivin PCOS veya non-PCOS klasör etiketlerini taşıyan görüntülerin sınıflandırılmasıdır. Bu, PCOS’un klinik ve biyokimyasal kriterleri gerektiren klinik bir tanı değildir ve arşivin bu kriterleri sağlamadığından bu kriterler mevcut değildir (). Mimari karşılaştırması buna göre, herhangi bir modelin polikistik over morfolojisini tanıdığına dair kanıt olarak değil, bu arşivdeki eşzamanlı eğitim davranışının bir temel ölçümü olarak yorumlanır.
Bu makalenin geri kalanı şu şekilde düzenlenmiştir. Bölüm 2, PCOS ultrasonografisinde derin öğrenme, tıbbi görüntülemede eşzamanlı öğrenme (FL) ve veri, değerlendirme protokollerinin ve açıklamaların denetimi konularındaki ilgili çalışmaları gözden geçirir. Bölüm 3, veri setini ve çoğaltma denetimini, eşzamanlı ayrıştırmayı, mimariyi, eğitim ve model seçim prosedürünü, kontrolleri, metrikleri ve istatistiksel testleri, Eşzanlı Güvenilirlik Puanını, açıklanabilirlik denetimini ve sızıntı ile kısa yola denetimi açıklar ve gösterimi özetler. Bölüm 4, deneysel kurulumu açıklar. Bölüm 5 sonuçları bildirir, Bölüm 6 bunları tartışır, Bölüm 7 çalışmanın sınırlamalarını belirtir, Bölüm 8 gelecekteki çalışmaları özetler ve Bölüm 9 makaleyi sonuçlandırır.
2 İlgili çalışmalar
2.1 PCOS ultrasonografisinde derin öğrenme
VGG-16, ResNet-50, DenseNet-121 ve MobileNetV2 gibi aktarım öğrenmeli CNN’ler PCOS ultrasonografisinde kullanılmış; bunların çoğu merkezileştirilmiş eğitimle gerçekleştirilmiş (–). Suha ve Islam, Bangladeş’te toplanan 594 over ultrasonografik görüntüsünde, konvolüsyonel özellikleri geleneksel sınıflandırıcıların yığılı birleşimi ve rastgele 70/30 ayrımıyla birleştirerek yaklaşık %99 doğruluk bildirmiş (). Zhao ve arkadaşları, iki merkezden prospektif olarak toplanan görüntüler üzerinde hasta düzeyinde ayrım ve dış geçerlilik ile bir derin öğrenme tanı modeli geliştirmiş (), Sundari ve arkadaşları ise ultrasonografik ve biyomarker verilerini birleştirerek Grad-CAM görselleştirmesiyle desteklenen EfficientNet-B3 modeliyle %94,8 doğruluk bildirmiş (). Bu alandaki yöntem ve sonuç yelpazesini özetleyen güncel bir derleme bulunmaktadır (). Bu çalışmaların hiçbiri burada analiz edilen Figshare arşivini kullanmamıştır; çoğu eşleşme kontrolü, güven aralıkları (GA) veya edinme yanlılıklarını dengeleme konusunda bilgi vermemiştir ve tüm modeller merkezileştirilmiş şekilde eğitilmiştir. Tıbbi görüntüleme yapay zekası için raporlama yönergeleri artık bu ayrıntıları açık biçimde istemektedir (, ).
2.2 Tıbbi görüntülemede federated öğrenme
FL, görüntüler birleştirilmeden kurumlar arasında paylaşımlı bir modeli eğitir (). FedAvg (federated averaging) yönteminde her site modelin yerel bir kopyasını eğitir ve sunucu ortaya çıkan ağırlıkları ortalar (). FedProx, heterojen istemciler arasında eğitimi stabilize etmek için proksimal bir terim ekler (), FedBN ise site arasındaki özellik kaymasını yönetmek için batch normalizasyon istatistiklerini yerelde tutar (). Çoklu kurumsal çalışmalar, FL’nin onkoloji ve yoğun bakımda merkezî olarak eğitilen modellerle yarışabileceğini göstermiş; ayrıca FL, ülkeler arası COVID-19 akciğer BT görüntülemesi için geçerliliği kanıtlanmıştır (). Tıptaki FL üzerine yapılan derlemeler, ana açık sorunları istatistiksel heterojenlik, gizlilik koruma ve değerlendirme pratiği olarak sıralar (). PCOS görüntülemesi, taramaların fertilite, jinekoloji ve endokrinoloji hizmetleri arasında dağılması bu ortama uygundur. Paylaşımlı öğrenme temelli kıyaslama setleri ise kendi hata kaynaklarını ekler: istemciler arasındaki etiket kayması, ki bu genellikle Dirichlet bölülemeleriyle simüle edilir (); batch normalizasyon istatistiklerinin birleştirilmesi (); eğitim sırasında sayısal kararsızlık; ve test bilgisini sızdıran model seçim kuralları.
2.3 Veri, değerlendirme ve açıklamaların denetlenmesi
Grad-CAM () gibi açıklama yöntemleri, bir ağılın foliküllere dikkat ettiğine dair kanıt olarak sık sık sunulur. Oysa saliyans haritaları makul görünebilirken eğitilen ağırlıklara duyarlı olmayabilir (); radyolojideki kıyaslama çalışmalarında, bu haritaların anormallikleri güvenilir biçimde yerelleştirmede çoğu zaman başarısız olduğu bulunmuştir (). Model rastgeleleştirme testleri () ve silme eğrileri (), klinik görüntülemede saliyansın görsel incelemesinin ötesine geçilmesine yönelik çağrılarla uyumlu bir şekilde bu haritalları daha doğrudan inceler (). Verilerin kendileri içinse, görüntüleri ayırmadan önce öbeklemeye (hash) göre gruplandırmak, hasta kimlik bilgisinin mevcut olmadığı durumlarda sızdırmayı önleyen pratik bir korumadır ().
3 Gereç ve yöntemler
Tüm deneyler, kamuya açık bir arşivin denetlenmiş, sabit bir bölümü kullanılarak ve her mimari aynı federative protokol altında eğitilerek gerçekleştirildi. Genel tasarım Şekil 1’de özetlenmiştir. Şekil 1A, Figshare arşivinin edinilmesinden yinelenme ve etiket çelişkisi denetimine, ön işlemeden grup bakımından ayrık istemci oluşturulmasına kadar olan veri hattını göstermektedir. Şekil 1B, sekiz temel modelin beş istemci üzerinde ayrı ayrı FedAvg çalışmasıyla eğitildiği ve sunucunun tüm ağırlıkları ile batch normalizasyonu istatistiklerini benzersiz eğitim görüntülerinin sayısına orantılı olarak ortalamaya aldığı bir federative turu göstermektedir. Şekil 1C, analizleri listelemektedir: performans ve istatistiksel testler, açıklanabilirlik denetimi, çoklu tohum sağlamlığı ve sızıntı ile kısa yol denetimi.
Şekil 1
Şekil 2
3.1 Veri seti ve yinelenme dentimi
Kamuya açık Figshare PCOS ultrason arşivi indirildi ve dosya dosya envanteri çıkarıldı. Etiketler, deposun klasör etiketleridir (“infected” PCOS, “noninfected” ise PCOS olmayan için). Hastaya ait kimlik bilgileri, edinim parametreleri veya Rotterdam ya da 2023 kılavuz kriterlerine göre klinik doğrulama mevcut değildir (, ). Her dosya, tam yinelenmeleri belirlemek için SHA-256 kriptografik işlevi ile işlendi. Benzersiz görüntüler ardından 64 bit algısal işlevlerle karşılaştırıldı ve a ile b görüntülerinin işlevleri ve olduğunda, Hamming mesafeleri en fazla 2 bit olduğunda yakın yinelenmeler olarak kabul edildi (Denklem 1). Karşılaştırma, döndürülmüş ve yansıtılmış kopyaların da gruplandırılması için görüntü a üzerinde dihedral grup D4’ün sekiz döndürme ve yansıması için tekrarlandı (Denklem 15, Bölüm 3.10). Gruplar, bu ilişkinin bileşen bağlantılı bileşenleri olarak tanımlandı (union-find) ve hem etiketlere sahip görüntüler içeren gruplar hariç tutuldu. Burada ve , a ile b görüntülerinin 64 bit algısal işlevleridir; popcount(.) özel ya da (xor) işleminden sonra farklılaşan bitleri sayar ve a ∼ b, iki görüntünün yakın yinelenmeler olduğunu belirtir.
3.2 Veri seti karakterizasyonu ve denetim sonucu
Arşiv 11.784 görüntü dosyası içermekteydi: PCOS klasöründe 6.784, PCOS olmayan klasöründe 5.000. Depo kaydı, önceki yayımlanmış halka açık veri setlerinden derlenen 12.680 görüntüden bahsetmekte (); bu 896 görüntülü fark arşiv içeriğiyle açıklanamamış ve görüntülerin özgün kaynakları belirlenememiştir. SHA-256’ya göre yalnızca 3.996 dosya benzersizdi, dolayısıyla 7.788 tam kopya kaldırıldı. Çoğalma, PCOS klasöründeki (6.784 dosyanın 3.600’ü, %53) yerine PCOS olmayan klasörde yoğunlaştı (5.000 dosyanın 4.188’i, %84). Dönüşüm bilinir eşleştirme, yalnızca döndürme veya çevirme sonrasında ortaya çıkan 1.709 benzer kopya bağlantısı buldu. Otuz sekiz benzer kopya grubu, her iki etikete de sahip görüntüler içeriyordu ve bu grupların 132 görüntüsü hariç tutuldu. Son veri seti, dönüşümsüz eşleştirme altında 2.822 grup yerine 2.345 grupta 3.864 görüntü (3.103 PCOS ve 761 PCOS olmayan) barındırdı; sınıf oranı yaklaşık dörtte birdi. Bu setin küresel test kümesi ve beş istemciye bölünmesi Tablo 1’de verilmiştir.
Tablo 1
| İstemci | Eğitim (PCOS olmayan/PCOS) | Eğitimden sonra aşırı örnekleme | Doğrulama | Yerel test | PCOS yaygınlığı (eğitim) |
|---|---|---|---|---|---|
| 0 | 285 (152/133) | 304 | 57 | 58 | 0.47 |
| 1 | 515 (83/432) | 864 | 103 | 103 | 0.84 |
| 2 | 788 (61/727) | 1.454 | 158 | 158 | 0.92 |
| 3 | 400 (36/364) | 728 | 117 | 80 | 0.91 |
| 4 | 191 (102/89) | 204 | 39 | 39 | 0.47 |
| Küresel test | — | — | — | 773 (152/621) | 0.80 |
İstemci bileşimi.
3.3 Grup ayrık federatif bölütleme
Tüm bölümlendirmeler grup düzeyinde yapıldı, böylece bir görüntü ve ona yakın kopyaları her zaman aynı bölüme ait oldu; bu özellik bir doğrulama ile teyit edildi. Stratejik bir grup bölümlendirmesi verinin %20’sini küresel bir test kümesi olarak ayırdı (773 görüntü, 461 grup, PCOS yaygınlığı 0,803). Geriye kalan geliştirme verisi, grup düzeyinde bir Dirichlet etiket bölümlendirmesiyle K = 5 simüle edilmiş istemciye dağıtıldı. Her bir c sınıfı için, istemci oranları yoğunluk α = 2,0 olan simetrik bir Dirichlet dağılımından çekildi ve o sınıfın grupları bu oranlar çerçevesinde ayrıldı (Denklem 2). Çekimler, her istemcinin her iki sınıfı da içerdiği ve en az 10 gruba sahip olduğu sürece tekrarlandı. Ardından her istemcinin verisi grup düzeyinde yerel eğitim, doğrulama ve test kümeleri olarak (70/15/15) bölündü. Bölümlendirme tek bir kez (bölümlendirme tohumu 42) üretildi ve her mimari, tohum ve deney için değiştirilmeden yeniden kullanıldı. Elde edilen istemci boyutları ve sınıf dengesi Tablo 1’de listelenmiş ve Ek Figure S1’de gösterilmiştir. burada pc, c sınıfının K istemciye ayrılan oranlarını, α Dirichlet yoğunluğunu (2,0), 1K K elemanlı bir birler vektörünü, Gc c sınıfının gruplarını ve Gck bu grupların k istemciye ayrılan alt kümesini ifade eder.
α = 2,0 değeri orta düzeyde bir etiket eğriliği üretti: İstemci PCOS yaygınlığı 0,47 ile 0,92 arasında değişti ve eğitim kümesi boyutu 191 ile 788 görüntü arasında değişti (Tablo 1). Bu değer, her istemcinin her iki sınıfı da içerdiği ancak sınıf dengelerinin belirgin biçimde farklı kaldığı şekilde seçildi; K = 5, her istemcide en az 190 eğitim görüntüsünün bulunmasını sağladı; α ve K’nın diğer değerleri incelenmedi (Bölüm 7). Sınıf dengeli aşırı örnekleme, yedekleme (with replacement) yalnızca yerel eğitim kümelerine uygulandı, böylece doğrulama ve test kümeleri orijinal sınıf dengelerini korudu. 0 ve 4 numaralı istemcilerin küçük yerel test kümeleri var (sırasıyla 58 ve 39 görüntü) ve 2 ile 3 numaralı istemciler yalnızca 12 ve 7 non-PCOS test görüntüsüne sahip, bu yüzden istemci başına skorlar betimleyici biçimde raporlanıyor.
3.4 Mimariler
Dört aşamadan, her biri ikişer 3×3 konvolüsyondan, batch normalizasyonundan ve bir sıkıştırma-uyarma (SE) bloğundan oluşan, bu çalışma için inşa edilen SE-CNN’in ardından 256-128-2 sınıflandırıcısı ve 0.3 dropout ile tamamlandığı belirtiliyor. SE bloğu, öğrenilen kapı kullanarak (Denklemin 3’e bakın) C kanallı X özellik haritasındaki her kanalı yeniden ölçeklendiriyor; burada δ ReLU fonksiyonu, σ lojistik fonksiyonu ve r azaltma genişliğidir. Diğer yedi sinir ağı, ImageNet üzerinde önceden eğitilmiş ve son katmanları iki sınıflı sınıflandırıcı ile değiştirilmiş olan torch vision’ın resmi uygulamaları olan AlexNet, VGG-16, GoogLeNet, ResNet-50, DenseNet-121, MobileNetV2 ve ShuffleNetV2’dir. Burada, H yüksekliği ve W genişliğine sahip bir özellik haritasında (i, j) konumsal konumundaki c kanalının aktivasyonu, kanal tanımlayıcısı ve iki tam bağlanmlı katmanın ağırlıkları, r azaltma genişliği, δ ReLU fonksiyonu, σ lojistik fonksiyonu ve c kanalını yeniden ölçeklendiren resulting kapıdır.
Tablo 2
| Model | Parametreler (M) | İstemci başına tur başına yükleme (MiB, FP32) | Başlatma | Batch norm | Öğrenme hızı | Doğruluk | Grad-CAM katmanı |
|---|---|---|---|---|---|---|---|
| SE-CNN | 1.22 | 4.7 | rastgele | evet | 1 × 10⁻³ | FP16 karışık | son SE bloğu |
| ShuffleNetV2 x1.0 | 1.26 | 4.9 | ImageNet | evet | 1 × 10⁻³ | FP32 | conv5 |
| MobileNetV2 | 2.23 | 8.6 | ImageNet | evet | 1 × 10⁻³ | FP32 | features.18 |
| GoogLeNet | 5.60 | 21.4 | ImageNet | evet | 1 × 10⁻³ | FP16 karışık | inception5b |
| DenseNet-121 | 6.96 | 26.9 | ImageNet | evet | 1 × 10⁻³ | FP16 karışık | denseblock4 |
| ResNet-50 | 23.51 | 89.9 | ImageNet | evet | 1 × 10⁻³ | FP16 karışık | layer4 |
| AlexNet | 57.01 | 217.5 | ImageNet | hayır | 1 × 10⁻⁴ | FP16 karışık | conv5 sonrası ReLU |
| VGG-16 | 134.27 | 512.2 | ImageNet | hayır | 1 × 10⁻⁴ | FP16 karışık | conv5_3 sonrası ReLU |
Mimari ve mimari başına ayarlar.
Hiçbir katman dondurulmadı ve GoogLeNet’in yardımcı sınıflandırıcıları kaldırıldı. Tek paylaşımlı bir yapılandırmadan sapmak için iki ayrı sapma gerekiyordu ve her iki sapma da test performansından çok, doğrulama verilerindeki çökme nedeniyle ortaya çıktı. İlk olarak, batch normalizasyonu içermeyen AlexNet ve VGG-16, 1 × 10⁻³ öğrenme hızında ıraksadı ve tüm deneylerde 1 × 10⁻⁴ ile eğitildi. İkinci olarak, MobileNetV2 ve ShuffleNetV2, 16-bit kayan nokta (FP16) karışık doğrulukta sonlu olmayan batch normalizasyonu istatistikleri üretti ve 32-bit kayan nokta (FP32) ile eğitildi. Başarısız olan tüm çalışmalar korundu ve her iki başarısızlık da gösterim çalışması olarak son bölütmede yeniden üretildi (Bölüm 5.7).
3.5 Fedelenmiş eğitim ve model seçimi
FedAvg () 20 iletişim turu boyunca, tur başına 2 yerel dönem ile çalıştırıldı. Her istemci, her turda sıfırlanan Adam optimizeri () (reset every round), 32 boyutunda batch ve odak kaybını (focal loss) γ = 2 () (Denklemler 4) kullanarak global modelin bir kopyasını eğitti; burada p doğru sınıfın tahmin edilmiş olasılığıdır. Mini-batch’ler, sınıf dengeli örneklem olasılıkları (Denklem 5) kullanılarak yerinde (replacement) çekildi ve böylece her dönemde, client k’nın daha büyük sınıfının boyutunun iki katı kadar örnek alındı. Sunucu, tüm kayan noktalı durumu, batch normalizasyon ağırlıkları ve koşullu istatistikleri dahil etmek üzere, her istemcinin benzersiz eğitim görüntülerinin sayısı ile ağırlıklandırdı (Denklem 6); ortaya çıkan ağırlıklar 0.131, 0.236, 0.362, 0.184 ve 0.088 oldu. Proximal terim, istemciye özgü normalizasyon veya sunucu momentumu kullanılmadı. Her istemci, tam FP32 durumunu (parametreler ve batch normalizasyon tamponları) her turda bir kez yükledi; Tablo 2’deki yükleme boyutları, indirileri, sıkıştırmayı ve protokol fazlasını hariç tutan teorik payload’ları MiB (220 byte) cinsinden göstermektedir.
Burada B mini-batch içindeki görüntü sayısıdır, pi i. görüntünün doğru sınıfının tahmin edilmiş olasılığıdır ve γ odak parametresidir; γ = 0 olduğunda ifade, çapraz entropi kaybına indirgenir.
Burada Nk,c k. istemcideki c sınıfına ait eğitim görüntüleri sayısıdır; dolayısıyla her sınıf, her dönemde çekilen görüntülerin yarısını katkı sağlar.
Burada Wt t. turdan sonra global durum, Wtk k. istemcinin yerel eğitimli durumu, Nk k. istemcideki benzersiz eğitim görüntüleri sayısı ve n bunların K istemci üzerindeki toplamıdır; ortalamalı durum, batch normalizasyon ağırlıklarını () ve koşullu istatistikleri (
Görüntüler 224 × 224 piksele boyutlandırıldı ve ImageNet istatistikleriyle normaliz edildi. Eğitim artırmaları (augmentation) yatay çevirme, 10 ayağa kadar döndürme ve hafif parlaklık/kontrast jitter’ından oluşuyordu (Ek Figure S2). Dikey çevirme, anatomik açıdan gerçekçi olmayan görünümler ürettiği için ana protokole dahil edilmedi ve etkisi ayrı ayrı test edildi (Bölüm 3.6).
Her turdan sonra global model, her istemcinin doğrulama kümesi üzerinde değerlendirildi. En yüksek ortalama istemci doğrulama dengeli doğruluğunu (BA) veren tur seçildi (Denklem 7) ve o turun modelinin global ve istemci test kümelerindeki metrikleri raporlandı. Test verileri asalse seçim veya ayar için kullanılmadı. Seçim kuralı deneylerden önce kesin olarak belirlendi. Her turun test metrikleri denetim amacıyla otomatik olarak kaydedildi, ancak yalnızca bir deneyin tüm çalışmaları tamamlandıktan sonra incelendi ve 20. tur sonuçları da birlikte raporlandı. Tam eğitim ve seçim prosedürü Algoritma 1’de verilmiştir. Burada t* seçilen tur, T iletişim sayısı (T = 20) ve BAtk, t turunun global modelinin k istemcisinin doğrulama kümesindeki dengeli doğruluğudur.
Algoritma 1
Girdi: istemciler k ∈ {1, …, K}; tur sayısı T; yerel dönem E; öğrenme hızı η
Çıktı: doğrulama ile seçilen global model θ* (t t* turu), global test ve istemci test metrikleri ve tur bazında doğrulama ve test kaydı
1: θ0’u başlat (ImageNet ağırlıkları ile yeni iki sınıflı baş; SE-CNN rastgele)
2: θ0 ← θ0
3: for t = 1’den T‘ye
4: for her istemci k için
5: Dk’den yerel eğitim; Adam’ı sıfırla
6: E dönem boyunca: Dk’den sınıf dengeli mini toplamlar örnekle (Denklem 5) ve odak kaybı (Denklem 4) üzerinde Adam ile wk’yi güncelle
7: θk ← FedAvg(θt-1, wk) (Denklem 6, toplu normalizasyon koşullu istatistiklerini dahil ederek)
8: BAtk ← BA(θk, Dk) (Denklem 7)
9: θk’nin ve BAtk’nin test metriklerini kaydet (seçim için kullanılmayan)
10: if BAtk > BAt*k ise; BAt*k ← BAtk, θt* ← θk
11: return θt*, Dglobal ve her Dk üzerinde raporla
3.6 Kontrol deneyleri
Ana deney ile aynı bölütleme ve tohum değerleri altında üç kontrol çalıştırıldı. Merkezi temeller, tüm istemcilerin eğitim verilerini birleştirerek aynı bütçe (40 epok) için eğitti ve tur seçimini, federasyonel çalışmalarda olduğu gibi istemci doğrulama dengeli doğruluklarının ortalaması üzerinden gerçekleştirdi; SE-CNN, DenseNet-121 ve VGG-16 için çalıştırıldılar, sonuncusu federasyonel çalışmalarıyla aynı 1 × 10⁻⁴ öğrenme hızında. Yalnızca yerel temeller, her istemcide yalnızca o istemcinin eğitim verileri üzerinde 40 epok için ayrı bir model eğitti ve seçimi istemcinin doğrulama kümesi üzerinden gerçekleştirdi; her istemci modeli kendi yerel test kümesi ve küresel test kümesi üzerinden puanlandırıldı ve küresel test metrikleri beş istemci modeli üzerinden ortalandı. SE-CNN ve DenseNet-121 için çalıştırıldılar. Merkezi ve yalnızca yerel çalışmalar, federasyonel çalışmalarla aynı başlatma, artırma, sınıf dengeli örnekleme, odak kaybı ve toplu boyutu kullandı, ancak her turda sıfırlanmak yerine tüm 40 epok için tek bir Adam optimizayorü korundu; 40 epok, bir federasyonel istemcinin 20 tur × 2 yerel epok’una denk gelir, ancak gradım adım sayısı eğitim kümesinin boyutuna göre değişir. Dikey çevirme dahilindeki silme çalışması, artırma hattına rastgele dikey çevirme eklenerek federasyonel SE-CNN ve DenseNet-121 eğitimini tekrarladı. Hesaplama sınırlamaları nedeniyle kontroller mimarilerin bir alt kümesini kapsadı: SE-CNN (rastgele başlatılan tek model) ve DenseNet-121 (toplu-normalleştirilmiş önceden eğitilmiş bir model) her kontrol için kullanıldı ve VGG-16, daha düşük öğrenme hızının federasyonel sonucu açıklamadığını doğrulamak için merkezili kontrole eklendi.
3.7 Metrikler ve istatistiksel analiz
PCOS pozitif sınıf olarak kabul edildi ve tahminler, tahmin edilen PCOS olasılığı üzerinde 0,5 sabit eşiği kullanıldı. Raporlanan metrikler dengeli doğruluk (BA; birincil son nokta), duyarlılık, özgüllük, kesinlik, PCOS için ikili F1, makro-F1 ve alıcı işletme karakteristik eğrisi altındaki alan (AUC)’dır; tanımları Denklem 8’de verilmiştir. Tanımsız oranlar sıfır olarak kabul edildi. Küresel test kümesinde tüm örnekleri PCOS olarak sınıflandıran çoğunluk sınıfı temel modelinin doğruluğu 0,803, dengeli doğruluğu 0,500 ve makro-F1 skoru 0,445’tir. İstemci arasındaki performans heterojenliği, istemci başına test dengeli doğruluğu, en kötü istemci değeri ve en iyi ile en kötü istemciler arasındaki fark ile tanımlanır. Burada TP, TN, FP ve FN, sırasıyla doğru pozitifler, doğru negatifler, yanlış pozitifler ve yanlış negatiflerin sayısıdır; PCOS pozitif sınıf olarak alınmıştır. Aynı denklem duyarlılığı (Sens), özgüllüğü (Spec), BA ve F1 skorunu tanımlar.
Her mimari, yeni katmanların başlatılması, veri sıralaması ve artırma işlemlerini kontrol eden üç önceden belirlenmiş tohum (42, 7 ve 99) ile eğitildi; bölütleme tüm çalışmalarda aynıydı. Referans model, seçilen turda en yüksek ortanca istemci doğrulama dengeli doğruluğuna sahip olan federatif mimari olduğu için test verisi kullanılmadan seçildi; bu DenseNet-121’di. Her diğer mimari için, küresel test dengeli doğruluğundaki eşleşik fark, grup bootstrap ile tahmin edildi: Küresel test kümesinin 461 yinelenen grubu yerinde yeniden örneklenerek (B = 2.000) alındı, çekilen bir grubun tüm görüntüleri yeniden örneklemeye birlikte alındı (Denklem 11) ve fark tohumlar üzerinden ortalandı (Denklem 9). Yüzdelik 95% Gİ’ler, yedi karşılaştırma için Bonferroni düzeltmeli aralıklarla birlikte bildirildi (1 − 0,05/7 düzeyinde, Denklemler 10). Tohumlar bağımsız tekrarlar olarak değil, ortalanarak değerlendirildi; bu nedenle aralıklar bu bölütleme için test kümesi örneklem belirsizliğini tanımlar; mevcut arşive koşulludur ve hastalar düzeyinde bağımsızlığı kanıtlamaz. Burada r referans modeli, m karşılaştırıcı modeli, S tohumların kümesi, b’inci bootstrap yeniden örneklemesi, iki modelin s tohumu için tahminleri ve B = 2.000 yeniden örnekleme üzerindeki 2,5. ve 97,5. yüzdelik dilimler arasında sınırlıdır. Burada Δ(q), B = 2.000 yeniden örnekleme üzerindeki bootstrap dağılımının q-quantili, α aile düzeyinde hata oranı ve M de referans modeliyle yapılan karşılaştırma sayısıdır. Burada test, küresel test kümesinin yinelenen gruplarının kümesi, b’inci yeniden örnekleme için yerinde rastgele uniforma çekilen G grubun çoklu kümesi, Ig g grubunun test indekslerini içerir ve G grup sayısıdır.
3.8 Federatif güvenilirlik skoru (keşif amaçlı)
Doğruluk, istemci arası tutarlılık ve kararlılığı tek bir sayıda özetlemek amacıyla, açıklayıcı bir Birleşik Güvenilirlik Puanı (FRS) tanımlanmıştır (Denklem 12). Bu puan, küresel dengeli doğruluk A, kötü istemci dengeli doğruluk W ve son beş tur üzerinde ortalama istemci doğrulama dengeli doğruluğunun standart sapması olan σ₅’ten hesaplanan bir kararlılık terimi S’yi τ = 0,10 değerleriyle birleştirir. A ve W, seçilen turda test verileri üzerinde hesaplanırken, σ₅ yalnızca doğrulama doğruluğunu kullanır; dolayısıyla puan, test sonuçlarının betimleyici bir özeti olup seçim için kullanılmaz. Eşit ağırlıklar varsayılan değerdir. Ağırlıklar ve eşik değinin klinik bir türetmesi bulunmadığından, FRS beş ağırlık ve üç eşik değeri (τ = 0,05, 0,10 ve 0,20) üzerinde bir duyarlılık analiziyle raporlanır, yorum bantları taşımaz ve model seçimi için hiçbir zaman kullanılmaz. σ₅, seçilen turdan bağımsız olarak 16–20 turları üzerinde hesaplandığından geç eğitim kararlılığını ölçer; seçilen turda biten beş tur üzerinde hesaplanan bir varyant Ek Tablo S3’te raporlanır. Eşit ağırlıklar hiçbir klinik tercih ifade etmez; bir uygulama ortamında, kuruluşlar arası tutarlılık W’ye daha yüksek bir ağırlık verilmesini gerekçelendirebilir. Burada A küresel dengeli doğruluk; W kötü istemci dengeli doğruluk; bileşen ağırlıklar; σ₅, son beş tur üzerinde ortalama istemci doğrulama dengeli doğruluğunun standart sapması; τ = 0,10, bir modele hiçbir kararlılık puanı verilmediği dalgalanma düzeyi; ve S, σ₅ τ‘ye yaklaştıkça 1’den 0’a doğrusal olarak azalır.
3.9 Açıklanabilirlik denetimi
Grad-CAM () yalnızca görsel incelemeyle değil, nicel olarak da değerlendirildi. Küresel test kümesinden önceden belirlenmiş bir örneklem çekildi: 30 rastgele PCOS görüntüsü, 30 rastgele PCOS olmayan görüntü ve referans modelin ilk tohumu tarafından yanlış sınıflandırılan 4 görüntü; toplamda 64. Her mimari için (tohum 42), PCOS-sınıf haritaları Tablo 2’de (Denklem 13) listelenen katmanda hesaplanır ve üç farklı şekilde değerlendirilir. Silme testinde () öne çıkan pikseller sırasına göre %10’luk adımlarda kaldırıldı, kaldır}pxkseller normalleştirme sonrası sıfıra eşitlendi (ImageNet ortalı renk) ve PCOS-sınıf olasılık eğrisinin altındaki alan kaydedildi (Denklem 14). İki rastgele sipariş kontrol olarak kullanıldı: piksel düzeyinde rastgele bir sipariş ve uzamsal olarak eşleştirilmiş bir kontrol; bu kontrolde, Grad-CAM katmanının yerel çözünürlüğündeki rastgele bir harita, Grad-CAM haritasıyla aynı şekilde büyütüldüğü için her ikisi de benzer boyutta bitişik bölgeleri kaldırır. Güvenilir bir harita, eşleştirilmiş kontrolden daha küçük bir alan vermelidir ve eşleşmeli fark görüntüler üzerinde bootstrap 95% aralığı ile özetlendi. Model rastgeleştirme testinde () eğitilen modelden gelen haritalar, ağırlıkları rastgele yeniden başlatılmış bir modelden gelen haritalarla (Spearman) korelasyonlandı ve düşük korelasyon, haritanın öğrenilen parametrelere bağlı olduğunu gösterir. Kararlılık, tohum 42 ve 7’nin modellerinden gelen haritalar arasındaki görüntü başına korelasyon olarak ölçüldü. Sıralamanın tanımlanamadığı sabit haritalar değerlendirilemez olarak işaretlendi ve ilgili istatistiğe dahil edilmedi. Uzman görüşleri mevcut olmadığı için anatomik uyum ölçülemedi. Burada () hedef mandanın kinci aktivasyon haritası, () (i, j) konumundaki değeri, () c sınıfının skoru, Z uzamsal konum sayısı, () kinci haritanın önem ağırlığı ve () resulting sınıf aktivasyon haritasıdır. Burada () normalleştirme sonrası öne çıkan pikselleri sıfıra eşitlenmiş görüntü, () ise ilgi sınıfının tahmin edilen olasılığıdır; daha düşük bir değer daha güvenilir bir haritayı işaret eder.
3.10 Sızıntı ve kısayol denetimi
Aynı bölümlendirmede üç kontrol daha gerçekleştirildi. İlk olarak, sızıntı denetimi, her bölümden her görüntü için diğer her bölümden en yakın görüntüyü sekiz D4 (Denklem 15) dönüşümü altında yeniden hesapladı ve 2 veya daha az Hamming uzaklığında eşleşmeleri saydı; test tahminleri ayrıca küresel test görüntülerinde, 6 uzaklığının içinde eğitim görüntüsü kalmayacak şekilde yeniden puanlandı. İkinci olarak, anatomik bilgi taşımayan görüntü özellikleri (genişlik, yükseklik, en-boy oranı ve piksel sayısı) üzerinde rastgele orman eğiten bir kısayol sorgusu geliştirme bölümünde eğitildi ve küresel test kümesinde puanlandı; ikinci sorgu dosya boyutu ve biçimini ekledi. Üçüncü olarak, eğitilen federatif modeller (tüm mimariler ve tohumlar) küresel test görüntülerinin manipüle edilmiş sürümleri üzerinde puanlandı: en-boy oranı, kareye doldurularak yeniden boyutlandırmadan önce korundu, dış %12’lik çerçeve masalandı (kenar kaldırıldı), yalnızca merkez yarısı korundu (yalnızca merkez) veya merkez yarısı masalandı (yalnızca çevre); masalanmış pikseller ImageNet ortalı renk değeri atandı. Bu manipülasyonlar, eğitilen modellerin çevresel ve geometrik ipuçlarını kullanıp kullanmadığını test eder; yalnızca bu ipuçlarının mevcut olduğunu göstermekten öteye geçmez. Burada D4, sekiz dörtlü dönüşüm kümesidir (0°, 90°, 180° ve 270°’lik döndürmeler ve çevirme ile) ve g dönüşümü sonrası i görüntüsünün algısal kodudur.
3.11 Gösterim
Denklem 1–15 ve Algoritma 1’de kullanılan semboller Tablo 3’te tanımlanmıştır. Bir harf farklı bir anlamda tekrar kullanıldığında, içinde geçtiği denklem belirtilmiştir.
Tablo 3
| Sembol | Tanımlama | Denklemler |
|---|
| İki görüntü ve 64-bit algısal kodları | , |
| İki algısal kod arasındaki Hamming uzaklığı |
| Sekiz dörtlü dönüşüm kümesi (0°, 90°, 180° ve 270°’lik döndürmeler ve çevirme ile); bu kümeden bir dönüşüm |
| K | İstemci sayısı (K = 5) | , , |
| c | Sınıf indeksi (PCOS veya PCOS olmayan) | , |
| Sınıf c’nin istemci oranları; Dirichlet yoğunluğu (α = 2.0) |
| Sınıf c’nin kopya grupları; k istemcisine atanmış c sınıfı grupları |
| Dir(·), | Simetrik Dirichlet dağılımı; K tane birden oluşan vektör |
| Özellik haritası, kanalı c, yüksekliği, genişliği ve kanal sayısı |
| , r | Kanal betimleyicisi, kanal kapısı, sıkıştırma-uyarlama ağırlıkları ve azaltma genişliği |
| δ(.), σ(.) | ReLU ve lojistik fonksiyonlar |
| B, γ | Mini toplu boyutu, doğru sınıfın tahmin edilen olasılığı, odak kaybında odaklama parametresi (γ = 2) |
| k istemcisindeki benzersiz eğitim görüntüleri, toplamları ve k istemcisinde c sınıfının eğitim görüntüleri | , |
| t turundaki küresel model durumu; k istemcisinin yerel durumu | , , Algoritma 1 |
| Toplu normalizasyon ölçeği, kayması, koşullu ortalama ve koşullu varyans |
| T, t* | Iletişim turu sayısı (T = 20); doğrulama ile seçilen tur | , Algoritma 1 |
| , E, η, | k istemcisinin eğitim, doğrulama ve yerel test kümeleri; tur başına yerel dönem sayısı (E = 2); öğrenme hızı; t turundaki küresel modelin istemci doğrulama dengeli doğruluğunun ortalaması |
| BA, | Dengeli doğruluk; istemci k’ın doğrulama kümesindeki dengeli doğruluk | , |
| TP, TN, FP, FN | Doğru olumlu, doğru olumsuz, yanlış olumlu, yanlış olumsuz |
| Sens, Spec, F1 | Duyarlılık, özgüllük ve F1-puanı |
| r, m, S, s | Referans model, karşılaştırıcı model, {42, 7, 99} tohum kümesi, tek tohum |
| Tohum s için referans ve karşılaştırıcı modellerin tahminleri |
| Sınama dizinlerinin grup tabanlı yeniden örnekleme b’si, tohumlar üzerinden ortalamalı dengeli doğruluk farkı, %95 yüzdelikli aralık |
| B | Yeniden örnekleme sayısı (B = 2.000; 4. denklemde B, mini-toplu boyutudur) | – |
| M, α, | Referans model ile karşılaştırmaların sayısı (M = 7), aile düzeyinde hata oranı (α = 0,05; 2. denklemde α, Dirichlet yoğunluğudur) ve Δb yeniden örnekleme dağılımının q-quantili |
| , G | Global sınama kümesinin eş grupları, b yeniden örneklemesi için değiştirerek alınan gruplar, g grubunun sınama dizinleri (15. denklemde g bir dönüştürmeyi ifade eder) ve grup sayısı (G = 461) |
| A, W, S | Global dengeli doğruluk, en kötü istemci dengeli doğruluk ve FRS’nin kararlılık terimi |
| Üç FRS bileşeninin ağırlıkları |
| σ₅, τ | 16–20. yuvalarda ortalamalı istemci doğrulama dengeli doğruluğunun standart sapması; kararlılık eşiği (τ = 0,10) |
| , Z | Hedef katmanın aktivasyon haritası, c sınıfının skoru ve konumsal pozisyon sayısı |
| Grad-CAM önem ağırlığı ve sınıf aktivasyon haritası |
| i/10 en belirgin pikselinin kaldırıldığı görüntü; c sınıfının tahmini olasılığı |
| Silme eğrisinin altındaki alan |
İşaretler.
4 Deney kurulumu
4.1 Donanım ve yazılım ortamı
Deneyler, tek bir NVIDIA RTX A4000 GPU (16 GB) üzerinde Python 3.12.3, PyTorch 2.12.0 (), torchvision 0.27.0 (NVIDIA konteyneri 26.05), CUDA 13.2 ve cuDNN 9.22 kullanılarak gerçekleştirildi. Uygulandığı yerlerde deterministik cuDNN kullanımı zorunlu kılındı; ancak uyarılı ortalama havuzlama için geriye doğru fonksiyon gibi bazı GPU işlemlerinin deterministik bir uygulaması olmadığından birden fazla çalıştırmanın küçük farklılıklar göstermesi bekleniyordu. Burada listelenen yazılım sürümleriyle analiz kodu https://github.com/priyankaMSP191606/PCOS-Polycystic-Ovary-Syndrome adresinde halka açık durumdadır. Dosya envanteri, özet değerleriyle veri ve istemci bölümleri, her çalıştırmanın tur bazlı kayıtları, tohum bazlı tahminler ve başarısız çalıştırmalar Ek Malzame’de sunulmaktadır.
Tüm deneylerde kullanılan donanım, yazılım sürümleri ve eğitim yapılandırması Tablo 4’te özetlenmektedir.
Tablo 4
| Öğe | Ayar |
|---|---|
| Ana GPU | NVIDIA RTX A4000 (16 GB); tüm mimariler ve kontrol deneyleri |
| İş istasyonu | Ubuntu 24.04 LTS, 24 çekirdekli CPU, 64 GB RAM, NVIDIA container toolkit içeren Docker |
| Yazılım (ana) | Python 3.12.3, PyTorch 2.12.0, torchvision 0.27.0 (NVIDIA container 26.05), CUDA 13.2, cuDNN 9.22 |
| İstemciler ve bölütleme | K = 5; grup düzeyinde Dirichlet etiketi bölütleme, α = 2.0; split tohumu 42 |
| T İletişim turu / yerel dönem | 20/2 |
| İyileştirici | Adam, her turda sıfırlanan |
| Öğrenme hızı | 1 × 10⁻³ (AlexNet ve VGG-16 için 1 × 10⁻⁴) |
| Toplu boyut | 32 |
| Kayıp ve örnekleme | Sınıf dengeli değiştirerek örnekleme ile Focal loss (γ = 2) |
| Toplama | Benzersiz eğitim görüntüleriyle ağırlandırılan FedAvg, batch normalizasyonu istatistiklerini de içerir |
| Sayısal hassasiyet | FP16 karma hassasiyet (MobileNetV2 ve ShuffleNetV2 için FP32) |
| Girdi ve artırma | 224 × 224, ImageNet normalizasyonu; yatay çevirme, 10 aya kadar döndürme, parlaklık ve kontrast titremesi |
| Model seçimi | En yüksek ortalama istemci doğrulama dengeli doğruluğuna sahip tur |
| Tohumlar | 42, 7 ve 99 |
| Merkezi kontrol | Birleştirilmiş eğitim verisi, 40 dönem, ortalama istemci doğrulama dengeli doğruluk üzerine seçilen tur; yalnızca yerel kontrol: istemci başına eğitim, 40 dönem, istemci doğrulama kümesi üzerine seçim |
Deneysel ortam ve eğitim yapılandırması.
4.2 Eğitim yapılandırması
Tüm mimariler, Bölüm 3’te tanımlanan ve Tablo 4 ile Algoritma 1’de özetlenen bölümlendirmeyi, dağıtık protokolü ve model seçim kuralını paylaştı. Yalnızca mimariye özgü farklar, AlexNet ve VGG-16’nın öğrenme hızı ile MobileNetV2 ve ShuffleNetV2’nın sayısal hassaslığıydı; bunlar Tablo 2’de listelenmiş ve Bölüm 3.4’te açıklanmıştır. Bölümlendirme tek kez oluşturulmuş ve her mimari, tohum ve kontrol deneyinde yeniden kullanılmıştır; böylece Bölüm 5’teki tüm karşılaştırmalar aynı test görüntülerine dayanmaktadır.
5 Bulgular
Bu bölüm, dağıtık kıyaslama, modeller arasındaki istatistiksel karşılaştırma, deney deneyleri, istemci başına ve iletişim sonuçları, keşif amaçlı güvenilirlik puanı, sayısal başarısızlık modları, açıklanabilirlik denetimi ve post hoc sızıntı ve kısayol analizlerini sunmaktadır.
5.1 Dağıtık kıyaslama
Tüm sekiz mimari üç tohumu tamamlamış ve doğrulama ile seçilen turdaki küresel test performansları, 42, 7 ve 99 tohumları üzerindeki ortalama ve standart sapma olarak Tablo 5’te özetlenmiştir. En kötü istemci sütunu, beş istemci arasındaki en düşük yerel test dengeli doğruluğunu vermektedir. Her model, çoğunluk sınıfı tahmincisine (Ek Şekil S3) karşı en az 0.983 dengeli doğruluğa ulaşmıştır. Dengeli doğruluk, duyarlılık, duyarlılık ve en kötü istemci dengeli doğruluğu Şekil 2’de gösterilmiştir. Duyarlılık her model için en az 0.989 olurken, duyarlılık daha fazla değişmiştir (0.978 ile 0.998 arası); çünkü PCOS olmayan görüntüler çoğu istemcide azınlık sınıfıdır.
Tablo 5
| Model | Dengeli doğruluk (seçilen tur) | Dengeli doğruluk (tur 20) | Hassasiyet | Özgüllük | Macro-F1 | AUC | En kötü istemci | Seçilen turlar |
|---|---|---|---|---|---|---|---|---|
| MobileNetV2 | 0.9951 ± 0.0016 | 0.9883 ± 0.0050 | 0.9925 | 0.9978 | 0.9899 | 0.9989 | 0.9726 | 3, 2, 9 |
| ShuffleNetV2 | 0.9929 ± 0.0017 | 0.9913 ± 0.0029 | 0.9946 | 0.9912 | 0.9905 | 0.9989 | 0.9672 | 18, 2, 4 |
| AlexNet | 0.9913 ± 0.0013 | 0.9913 ± 0.0005 | 0.9936 | 0.9890 | 0.9885 | 0.9985 | 0.9815 | 3, 18, 7 |
| DenseNet-121 | 0.9913 ± 0.0033 | 0.9913 ± 0.0033 | 0.9957 | 0.9868 | 0.9905 | 0.9980 | 0.9815 | 14, 9, 18 |
| VGG-16 | 0.9907 ± 0.0005 | 0.9911 ± 0.0028 | 0.9946 | 0.9868 | 0.9891 | 0.9978 | 0.9815 | 7, 2, 7 |
| GoogLeNet | 0.9907 ± 0.0029 | 0.9907 ± 0.0033 | 0.9946 | 0.9868 | 0.9891 | 0.9976 | 0.9638 | 10, 6, 19 |
| ResNet-50 | 0.9883 ± 0.0031 | 0.9883 ± 0.0039 | 0.9919 | 0.9846 | 0.9851 | 0.9987 | 0.9655 | 9, 19, 18 |
| SE-CNN | 0.9834 ± 0.0076 | 0.9829 ± 0.0035 | 0.9887 | 0.9781 | 0.9790 | 0.9976 | 0.9549 | 20, 19, 8 |
| Çoğunluk sınıfı | 0.5000 | — | 1.0000 | 0.0000 | 0.4455 | 0.5000 | — | — |
Global test kümesinde federative sonuçlar.
Önde gelen modellerin sıralaması dikkatle değerlendirilmelidir. MobileNetV2 ve ShuffleNetV2 en yüksek ortalamaları (0.995 ve 0.993) elde ederken, onları 0.004 farkla AlexNet, DenseNet-121, VGG-16 ve GoogLeNet (0.991) izlemiştir. AlexNet ve VGG-16, batch-normalize edilmiş modellerden (Bölüm 3.4) daha düşük bir öğrenme oranıyla eğitildiği için, bunlarla ilgili farklar yalnızca mimariye attributed edilemez. Rastgele başlangıç ile eğitilen tek ağ olan SE-CNN, en düşük ortalamaya ve tohumlar üzerinde en büyük değişkene sahiptir. Her mimari ve tohum için tur bazlı istemci doğrulama dengeli doğruluğu Şekil 3’te gösterilmektedir; burada yıldızlar seçilen turu, kesikli çizgi ise şans seviyesini (0.5) işaret etmektedir. AlexNet, VGG-16, MobileNetV2, ShuffleNetV2 ve GoogLeNet bir ile üç tur içinde kararlılığa ulaşırken, DenseNet-121 yaklaşık beş tur sonra kararlılığa ulaşmıştır; ResNet-50 ve özellikle SE-CNN ise eğitim boyunca dalgalanmıştır (SE-CNN tohum 7: 1. turda 0.51 ve 13. turda 0.73).
Şekil 3
5.2 İstatistiksel karşılaştırma
Doğrulama ile seçilen referans modelle (DenseNet-121) çiftli karşılaştırmalar Tablo 6’da sunulmaktadır. Aralıklar, küresel test setinin 461 yinelenen grubunun 2.000 grup-tabanlı yeniden örneklemesinden elde edilmiş olup, farklar tohumlar üzerinde ortalaması alınmıştır.
Tablo 6
| Karşılaştırma (referans: DenseNet-121) | Dengeli doğrulukta ortanca fark (referans eksi karşılaştırıcı) | 95% grup-bootstrap güven aralığı | 95% GC sıfırı içermez | Bonferroni düzeltmeli GC (99.29%) |
|---|---|---|---|---|
| MobileNetV2’ye karşı | −0.0039 | −0.0133 ile 0.0034 | Hayır | −0.0179 ile 0.0056 |
| ShuffleNetV2’ye karşı | −0.0017 | −0.0074 ile 0.0032 | Hayır | −0.0106 ile 0.0048 |
| AlexNet’e karşı | 0.0000 | −0.0066 ile 0.0067 | Hayır | −0.0100 ile 0.0093 |
| VGG-16’ya karşı | +0.0005 | −0.0062 ile 0.0073 | Hayır | −0.0096 ile 0.0103 |
| GoogLeNet’e karşı | +0.0005 | −0.0059 ile 0.0070 | Hayır | −0.0086 ile 0.0091 |
| ResNet-50’a karşı | +0.0030 | −0.0042 ile 0.0104 | Hayır | −0.0075 ile 0.0129 |
| SE-CNN’e karşı | +0.0079 | 0.0013 ile 0.0149 | Evet | −0.0008 ile 0.0180 |
Doğrulama aşamasında seçilen referans modelle (DenseNet-121) eşleştirilmiş karşılaştırmalar.
Yedi karşılaştırmada çokluluk düzeltmesi yapıldıktan sonra mimarilerin hiçbiri DenseNet-121’den farklı değildi; tüm Bonferroni düzeltmeli aralıklar sıfırı içeriyordu. MobileNetV2 ve ShuffleNetV2, referansın üzerinde nokta tahminlerine sahipti ve düzeltmesiz en geniş fark SE-CNN’e karşıydı (0.008; 95% GC 0.001–0.015) ancak bu düzeltme sonrasında korunmadı. Referans doğrulama verisi üzerinde seçildiğinden en yüksek test ortancasına sahip model değildir. Üç tohum ve 152 non-PCOS test görüntüsüyle bu sonuçlar her mimari için “üstün” yerine “karşılaştırılabilir” düzeyindedir; en fazla SE-CNN için geçici bir dezavantaj söz konusudur; algılanan farkın olmaması eşitliği kanıtlamaz, çünkü eşitlik test edilmemişti. Tohum başına değerler ve karışıklık sayıları Ek Tablo S1’de verilmiştir.
5.3 Merkezi, yalnızca yerel ve dikey çevirme kontrolleri
Federasyonun, yalnızca yerel eğitimin ve dikey çevirme veri artırmanın etkileri, 3.6 bölümünde açıklanan kontroller kullanılarak değerlendirildi; bu kontroller ana deneyle aynı ayrımı ve tohum değerlerini, 40 epoch’luk bir eğitim bütçesini kullandı. Bulgular Tablo 7’de listelenmiştir.
Tablo 7
| Model | Ayarlama | Dengeli doğruluk | Hassasiyet | Özgüllük | AUC | En kötü istemci |
|---|---|---|---|---|---|---|
| DenseNet-121 | Merkezi | 0.9869 ± 0.0051 | 0.9936 | 0.9803 | 0.9975 | 0.9664 |
| DenseNet-121 | Federasyonel | 0.9913 ± 0.0033 | 0.9957 | 0.9868 | 0.9980 | 0.9815 |
| DenseNet-121 | Federasyonel + dikey çevirme | 0.9916 ± 0.0005 | 0.9941 | 0.9890 | 0.9983 | 0.9815 |
| DenseNet-121 | Yalnızca yerel | 0.9607 ± 0.0146 | 0.9678 | 0.9535 | 0.9913 | 0.8467 |
| SE-CNN | Merkezi | 0.9892 ± 0.0033 | 0.9871 | 0.9912 | 0.9986 | 0.9815 |
| SE-CNN | Federasyonel | 0.9834 ± 0.0076 | 0.9887 | 0.9781 | 0.9976 | 0.9549 |
| SE-CNN | Federasyonel + dikey çevirme | 0.9824 ± 0.0075 | 0.9823 | 0.9825 | 0.9969 | 0.9611 |
| SE-CNN | Yalnızca yerel | 0.9193 ± 0.0199 | 0.9368 | 0.9018 | 0.9845 | 0.7169 |
| VGG-16 | Merkezi | 0.9894 ± 0.0022 | 0.9941 | 0.9846 | 0.9987 | 0.9815 |
| VGG-16 | Federasyonel | 0.9907 ± 0.0005 | 0.9946 | 0.9868 | 0.9978 | 0.9815 |
Merkezi, yalnızca yerel ve dikey çevirme kontrolleri.
Gruplandırılmış eğitimle karşılaştırıldığında, dağıtık eğitim DenseNet-121 için dengeli doğruluğu +0.004, SE-CNN için −0.006 ve VGG-16 için +0.001 değiştirdi (Tablo 7); tümü yaklaşık iki tohum standart sapması içindeydi, dolayısıyla dağıtıklığın maliyeti küçüktü ve işaretle tutarlı değildi. Yalnızca yerel eğitimde her istemci yalnızca kendi verilerini kullandı ve açıkça daha zifti: Beş istemci modeli üzerinden ortalamaya alındığında küresel test dengeli doğruluğu DenseNet-121 için 0.961 ve SE-CNN için 0.919’du, sırasıyla ilgili dağıtık modellerden 0.031 ve 0.064 daha düşüktü ve en kötü istemci dengeli doğruluğu 0.847 ve 0.717’ye düştü. İstemci başına, yerel test kümesinde dağıtıklıktan elde edilen ortalama artış DenseNet-121 için 0.006 ile 0.124 arasında, SE-CNN için −0.002 ile 0.283 arasında değişti, dolayısıyla her istemci kazanç sağlamadı; en büyük artışlar yalnızca 36 PCOS olmayan eğitim görüntüsünü içeren istemci 3’teydi (Ek Tablo S2). Dikey çevirme, DenseNet-121 için dengeli doğruluğu 0.001’den az, SE-CNN için −0.001 ve en kötü istemci dengeli doğruluğu 0.000 ve +0.006 değiştirdi. Diyece diye çevirmenin bu arşive ölçülebilir bir etkisi yoktu; ana protokole dahil edilmedi çünkü performansından dolayı değil, anatomik açıdan gerçekte olmayan görüntüler üretmesinden dolayı çıkarıldı.
5.4 İstemci başına performans
İstemci başına sonuçlar burada özetlenmekte ve tüm değerler Ek Tablo S2 ve Ek Şekil S5’te verilmektedir. Genellikle en zayıf istemci 0’dı; burada 27 PCOS test görüntüsü içindeki bir yanlış negatif dengeli doğruluğu 0.019 düşürdü ya da istemci 2’di; burada 12 PCOS olmayan test görüntüsü içindeki bir yanlış pozitif bunu 0.042 düşürdü. AlexNet, VGG-16 ve DenseNet-121 iyi ve kötü sonuçlar arasındaki en küçük ortalama farkı (0.019) gösterirken, GoogLeNet ve SE-CNN en büyük farkı (0.036 ve 0.045) gösterdi. İstemci 3 ve 4’ten gelen mükemmel puan, bu istemcilerin veri setlerindeki çok az görüntüden (istemci 3’te 7 PCOS olmayan görüntü ve istemci 4’te toplamda 39 görüntü) kaynaklanmakta, onlardan gelen herhangi bir üstün sonuçtan değil; dolayısıyla bu istemciler arası performans heterojenliği betimlenmekte, test edilmemektedir.
5.5 İletişim ve hesaplama
Bağlantı maliyeti mimariler arasında iki büyüklük derecesi kadar farklıydı (Tablo 2). Her istemci başına ve tur başına teorik FP32 yükleme (parametreler ve batch normalizasyon tamponları) 4,7 MiB (SE-CNN) ile 512 MiB (VGG-16) arasında değişiyordu. 20 tur ve 5 istemci üzerinden ShuffleNetV2 yaklaşık 0,47 GiB (230 bayt) güncelleme, AlexNet yaklaşık 21,2 GiB ve VGG-16 yaklaşık 50,0 GiB güncelleme yüklerdi; bu, istatistiksel açıdan ayırt edilemez bir doğruluk için 106 katlık bir farktır (Ek Figure S4). İndirmeler, sıkıştırma ve protokol fazlalıkları ölçülmedi. RTX A4000 grafik kartında federatif eğitim başına ortalama süre ShuffleNetV2 için 2,8 dk, GoogLeNet için 3,7 dk, AlexNet için 4,4 dk, SE-CNN için 5,2 dk, MobileNetV2 için 6,2 dk, ResNet-50 için 6,5 dk, DenseNet-121 için 7,7 dk ve VGG-16 için 14,9 dk’ydı. MobileNetV2 ve ShuffleNetV2 FP32 modunda çalıştığından bu süreler FP16 modellerin süreleriyle doğrudan karşılaştırılamaz. 24 federatif koşu 154 GPU-dk aldı; merkezi, yalnızca yerel ve dikey çevirme kontrolleri buna 175 GPU-dk daha ekledi ve başarısızlık gösterimleri 88 GPU-dk aldı (Ek Tablo S5).
5.6 Federatif güvenilirlik skoru
Bölüm 3.8’de tanımlanan keşif amaçlı FRS (eşit ağırlıklar, τ = 0,10, kararlılık 16–20. aralıktaki istemci doğrulama doğruluğu üzerinden hesaplandı) Şekil 4’te dengeli doğrulukla karşılaştırılmaktadır; her mimari için üç tohum üzerinden ortalamalı olarak. Değerler ve tam hassasiyet analizi Ek Tablo S3 ve Ek Figure S6’da verilmiştir.
Şekil 4
Eşit ağırlıklar kullanıldığında en yüksek FRS değerlerine AlexNet (0.983), ShuffleNetV2 (0.981) ve MobileNetV2 (0.973) ulaşırken, en düşük değeri ResNet-50 (0.917) aldı; bunun temel nedeni turdan tura istikrarsızlıktı (doğrulama σ₅ ortalamada 0.020 ve 42 tohumu için 0.031). 15 ağırlık ve eşik konfigürasyonu boyunca AlexNet 13 tanesinde birinci, ShuffleNetV2 kalan ikisinde birinci oldu; ResNet-50 12 konfigürasyonda son sırada, SE-CNN ise istikrarsızlık terimi içermeyen 3 konfigürasyonda son sırada yer aldı. σ₅, seçilen turda biten beş tur üzerinden hesaplandığında AlexNet yeniden birinci sıraya yükseldi (Ek Tablo S3). Dolayısıyla üst sıra ağırlığa bağlıydı ve model seçiminde FRS kullanılmadı.
5.7 Sayısal başarısızlık modları
Gelişim aşamasında, Tablo 2’deki ayarların benimsenmesinden önce iki konfigürasyon başarısız oldu ve her iki başarısızlık da gösterim çalışması olarak üç’er tohumla son ayrım üzerinde yeniden üretildi (Ek Tablo S4). Bu konfigürasyonların eğitim eğrileri, düzeltilmiş çalışmaların eğrileriyle Şekil 5’te karşılaştırılmıştır: FP16 ve FP32 modlarında MobileNetV2 ile ShuffleNetV2 ve öğrenme hızları sırasıyla 1 × 10⁻³ ve 1 × 10⁻⁴ olan AlexNet ile VGG-16.
Şekil 5
İki farklı mekanizma tespit edildi (Şekil 5). FP16 karma hassasiyet altında MobileNetV2 ve ShuffleNetV2’de her tohum ilk turdan itibaren sonlu olmayan çıktılar üretti: Tüm görüntüler karar eşiğinin altına düştü, dengeli doğruluk her turda 0,500 oldu ve AUC tanımsız kaldı. Geliştirme sürecinde sonlu olmayan değerlerin en az bir istemcide çalışan batch normalizasyonunun koşu istatistiklerinde aşırı taşmadan kaynaklandığı belirlendi; gradyan ölçeklendirici ağırlık güncellemelerini korur ancak bu arabellekleri korumaz ve FedAvg bu değerleri aynı turda tüm istemcilere aktardı. FP32’de her iki ağ da normal şekilde eğitildi (Tablo 5). Batch normalizasyonu olmayan AlexNet ve VGG-16, 1 × 10⁻³ öğrenme hızında güvenilir şekilde eğitilmedi: AlexNet üç tohumun tümünde sabit bir tahmine çöktü (dengeli doğruluk 0,500 ile 0,505 arası) ve VGG-16 kararsız eğitildi; tur boyunca ortalama istemci doğrulama dengeli doğruluğu 0,28 ile 0,93 arasında, seçilen tur test dengeli doğruluğu ise 0,922 ± 0,016 oldu. 1 × 10⁻⁴’te her iki ağ da 0,991’e ulaştı (Tablo 5). Başarısız olan hiçbir çalışma Tablo 5–8’e dahil edilmedi; bunlar Ek Tablo S4’te raporlanmaktadır.
Tablo 8
| Model | Silme AUC, Grad-CAM | Silme AUC, eşlenmiş rastgele kontrol | Fark, Grad-CAM eksi kontrol (95% GI) | Rastgeleleştirme Spearman (görüntüler) | Tohum kararlılığı (Spearman) |
|---|---|---|---|---|---|
| AlexNet | 0.479 | 0.874 | −0.403 (−0.468 ile −0.334) | 0.12 (61) | 0.31 |
| GoogLeNet | 0.426 | 0.772 | −0.379 (−0.421 ile −0.333) | hesaplanamaz (0) | 0.77 |
| ShuffleNetV2 | 0.466 | 0.821 | −0.355 (−0.421 ile −0.290) | 0.06 (62) | 0.60 |
| SE-CNN | 0.759 | 0.917 | −0.158 (−0.196 ile −0.126) | −0.19 (64) | 0.68 |
| MobileNetV2 | 0.306 | 0.403 | −0.126 (−0.149 ile −0.103) | −0.04 (58) | 0.49 |
| DenseNet-121 | 0.808 | 0.862 | −0.079 (−0.103 ile −0.057) | 0.12 (56) | 0.49 |
| VGG-16 | 0.606 | 0.592 | −0.019 (−0.087 ile 0.045) | 0.06 (57) | 0.31 |
| ResNet-50 | 0.932 | 0.897 | +0.035 (0.026 ile 0.045) | 0.10 (15) | 0.42 |
Nicel Grad-CAM denetimi.
5.8 Grad-CAM denetimi
3.9 bölümünde uygulanan testler, her mimarinin seed-42 modeli üzerinde gerçekleştirildi ve sonuçlar Tablo 8’de listelendi. Daha düşük silme AUC’si daha güvenilir bir haritayı işaret eder ve eşleşen kontrol ile yapılan farkın negatif olması Grad-CAM lehinedir. Rastgeleştirilen GoogLeNet modeli her görüntüde sabit haritalar üretirken, rastgeleştirilen ResNet-50 modeli 64 görüntünün 49’unda sabit haritalar ürettiğinden bu modellerin rastgeleştirme korelasyonları tanımsız ya da az sayıda görüntüye dayanmaktadır. Grad-CAM, altı mimari için eşleşme temelli rastgele kontrolden daha hızlı PCOS kanıtını ortadan kaldırdı; −0.079 (DenseNet-121) ile −0.403 (AlexNet) arasında değişen farklar ve sıfırı dışlayan %95 güven aralıkları bu üstünlüğü destekledi; ancak VGG-16 için fark sıfırdan ayırt edilebilir düzeyde değildi ve ResNet-50 için kontroller lehine sonuç verdi (+0.035). Küçük silmeleri tüm görüntüye yayarak ağları daha fazla bozan piksel düzeyindeki rastgele sıralamaya karşı ise Grad-CAM, DenseNet-121, ResNet-50 ve ShuffleNetV2 için daha zayıftı (Ek Tablo S6); bu nedenle hüküm kontrole bağlıdır. Eşleşen kontrol, aynı uzaysal ölçeğe sahip bölgeleri ortadan kaldırdığı için daha adil bir karşılaştırma sunar. Rastgeleştirme korelasyonları, hesaplanabildiği her model için düşüktü (−0.19 ile 0.12 arası) ve haritaların öğrenilen ağırlıklara bağlı olduğunu gösterdi; ancak GoogLeNet için hesaplanamadı ve ResNet-50 için 15 görüntüye dayandı. Tohumlar arasındaki kararlılık orta düzeydeydi (Spearman 0.31 ile 0.77) ve en düşük AlexNet ve VGG-16 için gözlemlendi. Sınıfa özgü sonuçlar Şekil 6B’de verilmiştir: eşleşen kontrole karşı üstünlük hem PCOS hem de PCOS olmayan görüntülerde AlexNet, GoogLeNet, ShuffleNetV2, SE-CNN, MobileNetV2 ve DenseNet-121 için geçerliyken, VGG-16 için her iki sınıfta da aralıklar sıfırı içeriyordu ve ResNet-50 için kontrol her iki sınıfta da daha güvenilirdi. Şekil 6A, sekiz mimarinin PCOS sınıfi haritalarını üç PCOS görüntüsü, iki PCOS olmayan görüntü ve referans model tarafından yanlış sınıflandırılmış bir PCOS görüntüsü üzerinde göstermektedir. PCOS görüntülerinden ikisinde haritaların çoğu folikül açısından zengin over bölgesini kapsarken; üçüncü görüntüde ve yanlış sınıflandırılmış görüntüde birkaç harita prob izine, görüntü kenarlarına ya da görüntünün üst kısmındaki dolgu şeridine yoğunlaşmıştır. PCOS olmayan görüntülerde haritalar
birçok mimari için zayıf ya da neredeyse boştu ve aynı görüntü üzerinde öne çıkan bölgeler mimariler arasında farklıydı. 64 denetlenmiş görüntünün tümünün görüntü başına puanları Ek Tablo S6’da verilmiştir.
5.9 Sızıntı denetimi ve edinme kısayolu
Sızıntı denetimi, bölümler arasında dönüştürülmüş kopya bulamadı; oysa kısayol analizleri, edinme ipuçlarının hem mevcut hem de kullanıldığını gösterdi. Kanıtlar Şekil 7’de özetlenmiştir: Şekil 7A sınıf başına görüntü genişliği ve yüksekliğini, Şekil 7B her küresel test görüntüsünün sekiz döndürme ve çevirme için en yakın eğitim görüntüsüne Hamming uzaklığını, Şekil 7C ise manipüle edilmiş test görüntülerinde federatif modellerin dengeli doğruluğunu göstermektedir.
Şekil 6
Dönüştürme bilincili gruplandırmadan sonra, hiçbir küresel test görüntüsünün sekiz döndürme veya çevirme altında Hamming uzaklığı 2 olan bir eğitim, doğrulama veya istemci görüntüsü bulunmadı ve bölümlerin diğer tüm çiftleri için de durum böyleydi (Şekil 7B; Ek Tablo S7). Arşiv yine de artırılmış kopyalar içeriyor; Image_Rotate serisi gibi dosya adları bunu gösteriyor. Dönüştürme bilincili eşleştirme olmadan oluşturulan önceki raporlanan bölümlerde test görüntülerinin %17,7’sinin geliştirme verilerinde döndürülmüş kopyası vardı. 409 küresel test görüntüsünde (126’sı PCOS olmayan) 6 uzaklık içinde eğitim görüntüsü bulunmamasına rağmen, federatif modellerin dengeli doğruluğu −0,003 ile 0,000 arasında değişti (Ek Tablo S10).
Edinme kısayolu güçlüydü. Tüm 761 PCOS olmayan görüntünün 4 sabit boyuttan biri ya da 90 derecelik döndürmeleri vardı (160 × 315, 436 × 630, 578 × 850 ve 848 × 984 piksel), oysa 3.103 PCOS görüntüsü daha küçüktü (orta 275 × 270 piksel) ve 1.333 farklı boyut alıyordu (Şekil 7A; Ek Tablo S8). Yalnızca genişlik, yükseklik, en-boy oranı ve piksel sayısı kullanan rastgele orman, küresel test kümesini mükemmel biçimde sınıflandırdı (dengeli doğruluk 1,000, AUC 1,000). En küçük PCOS olmayan görüntüler bile (160 × 315) PCOS görüntülerinde nadir olan 2:1 bir en-boy oranına sahiptir ve 224 × 224 piksele yeniden boyutlandırma, bu farkları görünür uzama ve enterpolasyon örüntülerine dönüştürür.
Girdi manipülasyonları, eğitilen federated modellerin bu ipuçlarını kullanıp kullanmadığını test etti (Şekil 7C; Ek Tablo S9). Bu testin yükleme hattı altında, değiştirilmemiş görüntüler yedi önceden eğitilen model için 0.001 içinde ana dengeli doğruluğu yeniden üretti ve SE-CNN için 0.918 verdi; tüm karşılaştırmalar bu değerlere göre yapıldı. Görüntünün merkezdeki yarısı masalandığında, beş mimari 0.91–0.98 dengeli doğruluk korudu (GoogLeNet 0.983, MobileNetV2 0.971, VGG-16 0.962, ShuffleNetV2 0.942 ve AlexNet 0.910) ve SE-CNN 0.898 iken, DenseNet-121 ve ResNet-50 sırasıyla 0.65 ve 0.66 seviyesine düştü ve büyük tohumdan tohuma değişimi gösterdi. Her görüntünün yalnızca merkezdeki yarısını korumak dengeli doğruluğu 0.50–0.75’e, dış 12% çerçeveyi masalamak ise 0.50–0.83’e düşürdü. Tüm içeriği koruyarak esneme desenini değiştiren kareye tamamlama, dengeli doğruluğu 0.82–0.93’e düşürdü ve bu düşüş neredeyse tamamen daha düşük duyarlılıktan kaynaklandı. Masalanmış görüntüler kendi başlarına dağılım dışı olduğundan, düşüşler yalnızca kısayola attributed edilemez; merkez kaldırıldığında korunan doğruluk ise modellerin çoğunun bu görüntüleri, yumurtlığın genellikle yer aldığı yerden uzakta, çevresel ve geometrik bilgilerden sınıflayabildiğini gösteriyor.
6 Tartışma
Bu çalışma, PCOS etiketli ultrason için veri, değerlendirme protokolü ve açıklamaların her biri denetlenen federated bir temel oluştordu. Çift kaldırma ve grup düzeyinde bölme sonrasında, sekiz mimarinin tamamı FedAvg altında 0.983 ile 0.995 arasında dengeli doğruluk sağladı. Denetim ayrıca, iki sınıfın yalnızca görüntü geometrisiyle ayrılabileceğini ve modellerin çoğunun görüntü merkezi masalandığında bu görüntüleri sınıflayabildiğini gösterdi; dolayısıyla bu sonuçlar, yumurta kesesi morfolojisinin tanısını değil, bu arşivdeki federated eğitim davranışını betimliyor.
Edinme kısayolu, bu çalışmanın en önemli bulgusudur. Görüntü boyutu ve en-boy oranı sınıfları birbirinden ayırmaya yeterlidir (Şekil 7A). Veri havuzu, görüntülerin önceki kamuya açık veri setlerinden derlendiğini belirtmekte (); PCOS olmayan görüntülerin sabit boyutları, iki sınıfın büyük ölçüde farklı kaynaklardan geldiğini düşündürmektedir. Her CNN girdileri 224 × 224 piksele boyutlandırdığı için, iki görüntü kaynağının gerilme ve enterpolasyon kalıpları modelin erişimine açık olmuş; deneyler over morfolojisini öğrenmeyi edinme kaynağını öğrenmekten ayıramamıştır. Federatif modellerin çoğu, her görüntünün merkezdeki yarısının maskelendiği durumda dengeli doğruluğu 0.90’ın üzerinde korumuştur (Şekil 7C) ve bazı görüntülerde Grad-CAM haritaları over yerine prob izi, kenarlar veya dolgu üzerinde yer almıştır (Şekil 6A); ikisi de kararlara over dışındaki ipuçlarının katkıda olduğunu göstermektedir. Aynı kalıp, veri setlerine göre eğitilen modellerin patoloji yerine hastane ve tarayıcı imzalarını öğrendiği göğüs radyografisinde tanımlanmıştır (, ) ve bu, kısayol öğrenmesinin textbook (temel) bir örneğidir (). 5–8 tablolarındaki doğruluk, bu arşivdeki performansı tanımlar ve PCOS tanıması için kanıt değildir. Görüntü geometrisini kontrol etmeyen bu veri seti üzerine yayılan sonuçlara aynı temkinlilik uygulanmalıdır. Dönüşüm bilinçli gruplama, bölümler arasındaki döndürülmüş ve çevrilmiş kopyaları tamamıyla kaldırmış; test setini herhangi bir yakın eşleşmesi olmayan görüntülerle sınırlamak dengeli doğruluğu en fazla 0.003 değiştirmiştir (Ek Tablo S10), bu da sızıntının sonuçları açıklamadığını, tıbbi görüntüleme yapay zekası üzerine metodolojik incelemelerle uyumlu olduğunu göstermektedir (, ).
Şekil 7
En iyi mimariler, dengeli ortalama doğruluk açısından birbirinden en fazla 0.004 ile ayrıldı ve doğrulama ile seçilen referansla yapılan hiçbir karşılaştırma çoklu karşılaştırma düzeltmesine dayanabildi (Tablo 7); bu nedenle kanıtlar tek bir en iyi mimariyi öne çıkarmıyor. ShuffleNetV2 ve MobileNetV2, sırasıyla 4.9 ve 8.6 MiB aktaran 1.3 ve 2.2 milyon parametreyle ortalama açısından en yüksek sonuçları verdi; buna karşılık AlexNet ve VGG-16 bu değeri sırasıyla 217.5 ve 512 MiB ile sağladı (Tablo 2). Siteler arasındaki bant genişliği sınırlıysa, sıkıştırılmış önceden eğitilmiş bir ağ makul bir seçimdir. MobileNetV2 en yüksek ortalamayı (0.995) ve özgüllüğü (0.998) elde etti; ancak en kötü istasyon puanı (0.973), AlexNet, DenseNet-121 ve VGG-16’nın puanından (0.982) düşüktü; bu öneri federatif eğitim davranışını kapsar ve edinim açısından eşleştirilmiş verilerde doğrulama gerektirir. AlexNet ve VGG-16, diğer modellerden daha düşük bir öğrenme hızıyla eğitildiği için onları içeren karşılaştırmalar optimizasyon ayarlarına göre kontrol edilmiyor.
SE-CNN, en düşük iletişim maliyetinde (tur başına 4.7 MiB) 0.983 dengeli doğruluk ve 0.998 AUC’ye ulaştı; ancak en düşük ortalamaya, tohumlar üzerinde en geniş dağılıma ve en kararsız eğitim eğrisine sahipti (Şekil 3) ve referansla arasındaki fark, düzeltilmemiş aralığın sıfırı dışarıda bıraktığı tek örnekti. Rastgele başlangıçtan eğitilen tek ağ da odur; bu açıklamanın bu açığı açıklayabileceği söylenebilir ancak bu hipotez test edilmedi. Bu nedenle SE-CNN, en iyi performansı gösteren model olarak değil, hafif bir temel (baseline) model olarak sunuluyor.
Pooled eğitimle karşılaştırıldığında, dağıtık eğitim dengeli doğruluğu −0,006 ile +0,004 arasında değiştirdi (Tablo 6) ve dağıtık modeller, tek bir istemcinin verileriyle eğitilen modellere göre 0,031–0,064 daha doğruydü. Kazanım, az sayıda non-PCOS eğitim görüntüsüne sahip istemcilerde yoğunlaştı ve bir istemci için SE-CNN’den kazanım sağlanamadı, böylece işbirliğinin yararı merkezler arasında dengesizdi. Non-PCOS eğitim görüntüleri istemciler arasında dengesiz olarak dağıldı (istemci başına 36–152) ve dağıtık ile merkezili eğitim arasındaki küçük fark, bölütleme ortalamasındaki orta düzey etiket eğriliğiyle tutarlıdir. Daha büyük, çoklu kurumsal çalışmalar da dağıtık ile merkezili eğitim arasında benzer şekilde küçük farklar bildirmiştir (–), ancak bu çalışmaların istemcileri tarayıcılar, popülasyonlar ve etiket dağılımı bakımından farklıydı.
MobileNetV2 ve ShuffleNetV2’nin bu görevde daha düşük performans gösterdiği yönündeki ilk izlenim, mimarilerden değil sayısal bir artefaktan kaynaklanıyordu (Şekil 5). Gösterim çalıştırmalarında, FP16 eğitim her tohumda ilk turdan itibaren sonlu olmayan çıktılar üretti. Batch normalizasyonunun koşullu istatistikleri kayıp ölçeklendirmesiyle korunmaz ve burada incelenen yapılandırmada istemciler arasında ortalanır, böylece bir istemcideki sonlu olmayan tampon bir tur içinde tüm istemcilere ulaşır; bu yayılım, normalizasyon tamponlarının birleştirilmesinin bir sonucudur, ancak ortaya çıkan taşma merkezili eğitimde de meydana gelebilir. Normalizasyon istatistiklerinin FedBN () örneğinde olduğu gibi yerel tutulması veya birleştirilen durumun sonlu olmayan değerler için kontrol edilmesi ucuz bir güvence sağlar. Öğrenme hızının 1 × 10⁻³ olduğu bir durumda AlexNet’in çökmesi ve VGG-16’nın dengesizliği, batch normalizasyonu olmayan ağlar için ayrı ve tanıdık normalizasyon sorunlarıdır (–).
Doğruluk da ResNet-50 ve SE-CNN için turdan tura değişti ve SE-CNN’in 7. tohumu, 13. turda doğrulama dengeli doğruluğunun 0.73 seviyesine geriledikten sonra toparladı (Şekil 3). Çoğu model için seçilen tur ile 20. tur sonuçları yakındı; ancak MobileNetV2 için 20. turda 0.007 daha düşük raporlanması gerekirdi (Tablo 5); bu nedenle seçim kuralının önceden belirtilmesi ve yalnızca doğrulama verisine uygulanması gerekir (Denklem 7; Algoritma 1). Tıbbi görüntüleme ve tahmin modellemesinde yapay zeka için güncel raporlama yönergeleri tam olarak bu düzeyde ayrıntı istemektedir (, , ).
Grad-CAM haritaları, öğrenilen ağırlıkların test edilebildiği durumlarda buna bağlıydı ve altı mimari için, kaldırıldığında PCOS olasılığını aynı uzaysal ölçeğe rastgele bölgelerin kaldırılmasından daha hızlı düşüren bölgeleri tespit etti (Tablo 8). Bu, haritaların modellere sadık olduğuna dair kanıt niteliğindedir, modellelerin foliküllere yöneldiğine dair değil: Aynı modeller, merkez maskelenmiş görüntüleri sınıflayabildi ve çoğu harita foliküllerin açıkça görüldüğü görüntülerde foliküllerle örtüşse de, diğer görüntülerde prob tabanı, kenarlar veya dolgu alanlarını kapsadı ve mimariler arasında farklılık gösterdi (Şekil 6A). Karar, ayrıca radyolojideki kıyaslama çalışmalarında belirginlik haritalarının genellikle anormallikleri güvenilir biçimde yerelleştirememesiyle uyumlu olarak kontrol seçimine de bağlıydı (, ). Makul görünen ısı haritaları dolayısıyla folikül temelli muhakemeye dair kanıt değildir ve klinikçilere yerelleştirme amacıyla anotasyonlu doğrulama olmadan gösterilmemelidir ().
PCOS ultrasonografisine yönelik daha önceki CNN çalışmalarında başka görüntü veri setleri kullanılmış, bazı durumlarda rastgele görüntü düzeyinde ayrılımlar uygulanmış; ancak burada analiz edilen arşiv hiçbirinde kullanılmadığı için bunlarla sayısal karşılaştırma anlamlı değildir. İki üçtebirinin tam kopya olduğu ve sınıfların görüntüleme geometrisinde farklılık gösterdiği bu arşitte yüksek doğruluk, modelin yararlanabileceği herhangi bir ipucuyla ne düzeyde sonuca ulaşılabileceğini gösterir. Over tümörü ultrasonografisine yönelik çok merkezli çalışmalar, güncel görevin henüz sahip olmadığı dış, çoklu merkez doğrulamasını ortaya koyar ve güncel çalışmalar bu farklı klinik görev için model performansını özetler; bu çalışmalar PCOS sınıflandırması için performans karşılaştırması değildir.
7. Sınırlamalar
Arşivde hasta veya muayene belirteci bulunmadığı için ayrılımlar, mevcut en katı seçenek olarak tam ve neredeyse özdeş görüntülerden oluşan gruplar üzerinde yapılmıştır; aynı hastaya ait, özdeş olmayan görüntüler farklı bölümlere düşebilir. Etiketler, klinik doğrulama belgelenmeden repository klasör etiketleridir, böylece görev klinik PCOS tanısı değil, repository etiketli ultrasonografik görünümün sınıflandırılmasıdır. Arşivde yayımlanan meta verideki 12.680 dosyaya karşılık 11.784 dosya bulunuyordu ve görüntüleme cihazları, merkezleri ve protokoller belgelenmemiştir. İstemciler tek bir veri setinin bölünmesiyle simüle edilmiştir, dolayısıyla heterojenlikleri etiket kaymasını yansıtır; tarayıcılar, operatörler veya popülasyonlar arasındaki farklılıkları yansıtmaz ve sonuçlar gerçek çok kurumlu ortamlara aktarılmayabilir.
Sadece paylaşılan batch normalizasyonu istatistikleriyle FedAvg değerlendirildi; FedBN, proksimal yöntemler ve istemci sayısı ile Dirichlet konsantrasyonu üzerindeki tarama incelenmedi. Merkezi kontroller üç mimariyi, yalnızca yerel ve dikey çevirme kontrolleri ise iki mimariyi kapsadı, dolayısıyla bu karşılaştırmalar her modele yayılmıyor. AlexNet ve VGG-16 öğrenme hızı olarak 1 × 10⁻⁴, MobileNetV2 ve ShuffleNetV2 ise FP32 kullanırken, diğer modeller 1 × 10⁻³ öğrenme hızı ve FP16 paylaştı; bu değişiklikler doğrulama verisinde çökme nedeniyle ortaya çıktı, ancak mimari karşılaştırmanın normalizasyon ayarları açısından tam olarak kontrol edilmediği anlamına geliyor. Üç tohum ve 152 non-PCOS görüntüsünden oluşan test kümesi, dengeli doğrulukta 0.01’den az farkla ayrılan modelleri ayırt etmek için sınırlı güce sahip; 7 ve 12 non-PCOS görüntüsünden oluşan istemci test küleri ise istemci başına tahminleri kaba kılıyor.
Grad-CAM, her mimari için bir tohum üzerinde sadakat ve sağlamlık testleriyle değerlendirildi, ancak uzman anatomik açıklaması veya kör klinik değerlendirmesiz olduğu için haritalar doğrulanmış folikül lokalizasyonu olarak okunamaz. Federe Sağlamlık Puanı’nın ağırlık veya eşiği için klinik bir dayanağı yoktur, en üst sırası ağırlıklandırmaya göre değişir ve dağıtım ölçütü olarak önerilmiyor. Son olarak, görüntü boyutu ve en-boy oranı test kümesini mükemmel biçimde sınıflandırıyor ve giriş manipülasyonları çoğu modelin çevresel bilgilerden sınıflandırabileceğini gösteriyor; ancak maskelenmiş görüntüler eğitim sırasında görülen görüntülerden farklı olduğu için bu manipülasyonlar modellerin kısayolu kullanabildiğini gösteriyor, ancak bu kısayola ne kadar güvendiğini tam olarak ölçemiyor. Ayrıca hiçbir model geometri kontrollü ön işleme ile eğitilmedi.
8 Gelecek çalışmalar
Gelecek çalışmalar, bu çalışmanın başlıca sınırlamalarını ele alacaktır. İlk olarak, geometrik kontrolü yapılan ön işleme ile eşitleme yerine sabit boyutlu kırpma veya dolgu ve eğitim sırasında çevresel bölgelerin maskelenmesi kullanılarak benchmark tekrarlanacak ve anatomik içeriğin katkısı, edinme özelliklerinin katkısından ayrılabilecektir. İkinci olarak, çerçeve birkaç kurumdan klinik olarak doğrulanmış hasta tanımlayıcılı ses görüntüleme verileri üzerinde değerlendirilecek; böylece bölütleme hasta düzeyinde yapılabilecek ve istemci heterojenliği tarayıcılar, operatörler ve popülasyonlardaki gerçek farkları yansıtacaktır.
Üçüncü olarak, karşılaştırma istemciye özgü normalleştirme (FedBN), proksimal yöntemler ve farklı sayıda istemci ve Dirichlet konsantrasyonlarına genişletilecektir. Merkezi, yalnızca yerel ve dikey çevirme kontrolleri de tüm mimariler için tek bir öğrenme oranı ve sayısal hassasiyet kullanılarak çalıştırılacaktır. Dördüncü olarak, açıklamalar folikül ve over sınırlarına dair uzman açıklamaları ile değerlendirilecek; gizliliği koruyan mekanizmalar, örneğin farklılaşmış gizlilik ve güvenli toplama, doğruluk ve iletişim maliyeti üzerindeki etkileri açısından değerlendirilecektir.
9 Sonuçlar
Bu halka açık PCOS ses görüntüleme arşivindeki dosyaların yaklaşık üçte biri tam kopya, 1.709’u yalnızca döndürme veya çevirme sonrasında ortaya çıkan yakın kopya bağlantılarıdır ve iki sınıf yalnızca görüntü boyutlarından ayrılabilir. Dönüşüm bilincinde, grup düzeyinde bölütleme ile federatif CNN’ler dengeli bir doğruluk değeri olan 0.983–0.995’ye ulaşmış; çoklu karşılaştırma düzeltmesinden sonra hiçbir model doğrulama ile seçilen referanstan farklılaşmamıştır. MobileNetV2 ve ShuffleNetV2 gibi kompakt öğretilmiş ağlar, iletişim maliyetinin küçük bir oranında en yüksek ortalık doğruluğa ulaşmış; ancak büyük modellerden farkları istatistiksel olarak algılanamamış ve eşitlik test edilmemiştir.
İki hata modu—federatif birleştirme tarafından her istemciye yayılan parti normalizasyonu istatistiklerinin FP16 bozulması ve batch normalizasyonu olmadan ağların ıraksaması—mimari zayıflıklar gibi yorumlanabilir ve düzenli olarak kontrol edilmesi değerlidir. Grad-CAM haritaları, sekiz modelin altısında mekânsal olarak eşleştirilmiş rastgele kontrolden daha güvenilir çıktı, ancak çoğu model görüntü merkezi maskelenmiş olsa da görüntüleri sınıflayabiliyordu. Bu edinme kısayolu nedeniyle, bu arşivdeki yüksek doğruluğun bir modelin polikistik over morfolojisini tanıdığını göstermediği söylenebilir. Arşiv, federatif eğitim davranışını çalışmak için kullanışlı olmaya devam ederken, PCOS sınıflandırıcılarının birkaç merkezden gelen hasta kimlik bilgileri içeren klinik olarak doğrulanmış, edinme açısından eşleştirilmiş veriler üzerinde doğrulanması gerekmektedir.
Açıklamalar
Veri erişilebilirliği açıklaması
Bu çalışmada kamuya açık veri setleri analiz edildi. Ultrason görüntüleri Figshare arşivinde https://figshare.com/articles/dataset/PCOS_Dataset/27682557?file=50407062 adresinde erişilebilir. Analiz kodu https://github.com/priyankaMSP191606/PCOS-Polycystic-Ovary-Syndrome adresinde mevcuttur. Tohum başına ve istemci başına sonuçlar, başarısız ve gösterim çalışmaları ile sızıntı ve kısayol denetimleri Ek Malzeme içinde raporlanmıştır. Dosya düzeyinde envanter, ayrım ve istemci-atama tabloları, tur başına eğitim günlükleri ve tohum başına tahminler ilgili yazardan makul talep üzerine temin edilebilir.
Yazar katkıları
DP: Kavramsal çerçeve, Veri düzenleme, Resmi analiz, Yöntem, Doğrulama, Görselleştirme, Yazım – taslak, Yazım – inceleme & düzenleme. KS: Kavramsal çerçeve, Veri düzenleme, Resmi analiz, Yöntem, Proje yönetimi, Gözetim, Doğrulama, Görselleştirme, Yazım – taslak, Yazım – inceleme & düzenleme.
Finansman
Yazar(lar), bu çalışma ve/veya yayın için finansal destek alındığını bildirmiştir. Erişim açık finansmanı Vellore Teknoloji Enstitüsü tarafından sağlanmıştır.
Çıkar çatışması
Makale yazarları, bu çalışmanın olası bir çıkar çatışması olarak değerlendirilebilecek herhangi bir ticari veya finansal ilişki olmadan yürütüldüğünü beyan ederler.
Üretken yapay zeka bildirimi
Makale yazarları, bu el yazısının oluşturulmasında üretken yapay zekanın kullanılmadığını beyan ederler.
Makaledeki figürlerle birlikte sağlanan alternatif metinler (alt text), yapay zekanın desteğiyle Frontiers tarafından oluşturulmuş olup, mümkün olduğunca yazarlar tarafından gözden geçirilmesi de dahil olmak üzere doğruluğun sağlanması için makul çabalar sarf edilmiştir. Herhangi bir sorun tespit etmeniz durumunda lütfen bizimle iletişime geçin.
Yayıncı notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini kesin olarak temsil etmeyebilir. Bu makalede değerlendirilen herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
Ekleme materyali
Bu makalenin Ekleme Materyaline şu çevrimiçi adresen ulaşılabilir: https://www.frontiersin.org/articles/10.3389/fdgth.2026.1980374/full#supplementary-material
-
1.
Tay C, Garrad R, Mousa A, Bahri M, Joham A, Teede H. Polystistik over sendromu (PCOS): kanıtları çevirme ve geleceğin araştırmalarını yönlendirme için uluslararası işbirliği. J Endocrinol. (2023) 257(3):e220232. 10.1530/JOE-22-0232
-
2.
Teede HJ, Tay CT, Laven JJ, EDokras A, Moran LJ, Piltonen T, ve ark. Polystistik over sendromunun değerlendirilmesi ve yönetimi için 2023 uluslararası kanıta dayalı rehberden öneriler. Eur J Endocrinol. (2023) 189(2):G43–64. 10.1093/ejendo/lvad096
-
3.
Rotterdam ESHRE/ASRM Destekli PCOS Uzlaşılan Çalıştay Grubu. Polisistik over sendromuyla ilişkili tanı kriterleri ve uzun vadeli sağlık risklerine dair revize edilmiş 2003 uzlaşı. Fertil Steril. (2004) 81(1):19–25. 10.1016/j.fertnstert.2003.10.004
-
4.
SuhaSA Islam MN. Over ultrasonografik görüntüleri kullanarak polisistik over sendromunun tespitinde genişletilmiş bir makine öğrenmesi tekniği. Sci Rep. (2022) 12(1):17123. 10.1038/s41598-022-21724-0
-
5.
Zhao B Wen L Huang Y Fu Y Zhou S Liu J ve ark. Polisistik over ultrasonografik görüntüleri için derin öğrenmeye dayalı otomatik tanı modeli. Balkan Med J. (2025) 42(5):419–28. 10.4274/balkanmedj.galenos.2025.2025-5-114
-
6.
Sundari MS Sailaja N V Swapna D Vikkurty S Jadala V C Durga K ve ark. Bütünleştirici ultrasonografik ve biyomarker temelli tanıda öğrenme aktarımıyla zenginleştirilmiş CNN modeli. Sci Rep. (2025) 15:34519. 10.1038/s41598-025-17711-w
-
7.
Wang J Chen R Long H He J Tang M Su M ve ark. Polisistik over sendromunun yönetiminde yapay zeka: geçmiş, günümüz ve gelecek. Radiol Med. (2025) 130(9):1409–41. 10.1007/s11547-025-02032-9
-
8.
Roberts M Driggs D Thorpe M Gilbey E Yeung M Ursprung S ve ark. Göğus radyografları ve BT taramaları kullanarak COVID-19’u tespit etmek ve prognozlamak için makine öğrenmesinin kullanımında yaygın hatalar ve öneriler. Nat Mach Intell. (2021) 3(3):199–217. 10.1038/s42256-021-00307-0
-
9.
Kapoor S, Narayanan A. Makine öğrenimi tabanlı bilimdeki sızıntı ve yeniden üretilebilirlik krizi. Patterns. (2023) 4(9):100804. 10.1016/j.patter.2023.100804
-
10.
Varoquaux G, Cheplygina V. Tıbbi görüntülemede makine öğrenimi: metodolojik hatalar ve gelecek için öneriler. NPJ Digit Med. (2022) 5(1):48. 10.1038/s41746-022-00592-y
-
11.
Geirhos R, Jacobsen J-H, Michaelis C, Zemel R, Brendel W, Bethge M ve ark. Derin sinir ağlarında kısa yolla öğrenme. Nat Mach Intell. (2020) 2(11):665–73. 10.1038/s42256-020-00257-z
-
12.
DeGrave A, JanizekJ D, Lee S I. Radyografik COVID-19 tespiti için yapay zeka, sinyal yerine kısa yolları seçiyor. Nat Mach Intell. (2021) 3(7):610–9. 10.1038/s42256-021-00338-7
-
13.
Zech J R, Badgeley M A, Liu M, Costa A B, Titano J J, Oermann E K. Akciğer grafilerinde pnömoniyi tespit etmede derin öğrenme modelinin değişken genelleşme performansı: kesit çalışması. PLoS Med. (2018) 15(11):e1002683. 10.1371/journal.pmed.1002683
-
14.
Mongan J, Moy L, Kahn C E. Tıbbi görüntülemede yapay zeka için CHECKLIST (CLAIM): yazarlar ve hakemler için bir kılavuz. Radiol Artif Intell. (2020) 2(2):e200029. 10.1148/ryai.2020200029
-
15.
Collins G, Maoons KGM, Dhiman PR, Riley RD, Beam AL, Van Calster B ve ark. TRIPOD+ AI bildirisi: regresyon veya makine öğrenimi yöntemleri kullanan klinik tahmin modellerinin raporlanması için güncellenmiş rehber. Br Med J. (2024) 385:e078378. 10.1136/bmj-2023-078378
-
16.
McMahan H, Moore B, Ramage D, Hampson S, Agüera y Arcas B. Merkezi olmayan verilerden derin ağların iletişim verimli öğrenimi. In: 20. Uluslararası Yapay Zeka ve İstatistik Konferansı (AISTATS) (PMLR) Bildirileri (2017), 54, 1273–82
-
17.
Rieke N, Hancox J, Li W, Milletarì F, Roth H, Albarqouni S ve ark. Federated learning ile dijital sağlığın geleceği. NPJ Digit Med. (2020) 3:119. 10.1038/s41746-020-00323-1
-
18.
Li T, Sahu AK, Zaheer M, Sanjabi M, Talwalkar A, Smith V. Heterojen ağlarda federated optimizasyon. Proc Mach Learn Syst. (2020) 2:429–50. 10.48550/arXiv.1812.06127
-
19.
Li X, Jiang M, Zhang X, Kamp M, Dou Q. FedBN: yerel batch normalizasyonu ile non-IID özelliklerde federated learning. In: International Conference on Learning Representations (ICLR) (2021).
-
20.
Sheller MJ, Edwards B, Reina GA, Martin J, Pati S, Kotrotsou A ve ark. Tıpta federated learning: hasta verisi paylaşmadan çok kurumlu işbirliklerinin kolaylaştırılması. Sci Rep. (2020) 10(1):12598. 10.1038/s41598-020-69250-1
-
21.
PatiSBaidUEdwardsBShellerMWangS-HReinaGA et al. Birleşik öğrenme, nadir kanserlerde sınır tespiti için büyük veri imkânı sağlar. Nat Commun. (2022) 13(1):7346. 10.1038/s41467-022-33407-5
-
22.
DayanIRothHRZhongAHarouniAGentiliAAbidinAZ et al. COVID-19’lu hastalarda klinik sonuçların tahmini için birleşik öğrenme. Nat Med. (2021) 27(10):1735–43. 10.1038/s41591-021-01506-3
-
23.
DouQSoTYJiangMLiuQVardhanabhutiVKaissisGet al. BT’lerde COVID-19 akciğer anormalliklerinin tespitinde birleşik derin öğrenme: Gizliliği koruyan çok uluslu geçerlilik çalışması. NPJ Digit Med. (2021) 4(1):60. 10.1038/s41746-021-00431-6
-
24.
KaissisGAMakowskiMRRueckertDBrarenRF. Tıbbi görüntülemede güvenli, gizliliği koruyan ve birleşik makine öğrenmesi. Nat Mach Intell. (2020) 2(6):305–11. 10.1038/s42256-020-0186-1
-
25.
GuanHYapPTBozokiALiuM. Tıbbi görüntü analizi için birleşik öğrenme: Bir derleme. Pattern Recognit. (2024) 151:110424. 10.1016/j.patcog.2024.110424
-
26.
KairouzPMcMahanHBAventBBelletBennisMBhagojiAN. Birleşik öğrenmede ilerlemeler ve çözülmeyi bekleyen sorunlar. Found Trends Mach Learn. (2021) 14(1-2):1–210. 10.1561/2200000083
-
27.
Li Q, Chen Q, He B. İletişimsel öğrenme: dağıtık veri yığınlarında deneysel bir çalışma. 2022 IEEE 38. Uluslararası Mühendislik Konferansı (ICDE) içinde (Kuala Lumpur: IEEE) (2022), 965–78
-
28.
Zhu H, Xu J, Liu S, Jin Y. İletişimsel öğrenme: dağıtık verilerde bir derleme. Neurocomputing. (2021) 465:371–90. 10.1016/j.neucom.2021.07.098
-
29.
Selvaraju RR, Cogswell M, Das A, Vedantam R, Parikh D,atra D. Grad-CAM: gradyan tabanlı konumlandırma yoluyla derin ağlardan görsel açıklamalar. Int J Comput Vis. (2020) 128(2):336–59. 10.1007/s11263-019-01228-7
-
30.
Adebayo J, Gilmer J, Muelly M, Goodfellow I, Hardt M, Kim B. Öne çıkan bölgeler haritaları için sağlıktan geçirmeler. Advances in Neural Information Processing Systems 31 (NeurIPS) içinde (2018), 9505–15
-
31.
Arun N, Gaw N, Singh P, Chang K, Aggarwal M, Chen B ve ark. Tıbbi görüntülemede anormallikleri konumlandırmada öne çıkan bölgeler haritalarının güvenilirliğinin değerlendirilmesi. Radiol Artif Intell. (2021) 3(6):e200267. 10.1148/ryai.2021200267
-
32.
Saporta A, Xu X, Agrawal A, Pareek A, Truong S, QH Nguyen CDT ve ark. Göğüs röntgeni yorumlaması için öne çıkan bölgeler yöntemlerinin karşılaştırmalı değerlendirmesi. Nat Mach Intell. (2022) 4(10):867–78. 10.1038/s42256-022-00536-x
-
33.
Petsiuk V, Das A, Saenko K. RISE: siyah kutu modellerinin açıklaması için rastlantısal giriş örnekleme. Proceedings of the British Machine Vision Conference (BMVC) içinde (2018).
-
34.
Borys K, Schmitt YA,auta M, Seifert C, Krämer N, Friedrich C, et al. Açıklanabilir yapay zeka tıbbi görüntülemede: Klinik uygulayıcılar için bir genel bakış—saliyans tabanlı XAI yaklaşımlarının ötesinde. Eur J Radiol. (2023) 162:110786. 10.1016/j.ejrad.2023.110786
-
35.
Indirani A. PCOS Veri Seti [Veri Seti]. figshare (2024). Çevrimiçi erişim: https://figshare.com/articles/dataset/PCOS_Dataset/27682557 (Erişim tarihi: 27 Haziran 2025).
-
36.
Ioffe S, Szegedy C. Batch normalization: internal covariate shift’i azaltarak derin ağ eğitimini hızlandırmak. In: Makine Öğrenimi 32. Uluslararası Konferansı (ICML) (PMLR) (2015), 37, 448–56
-
37.
Hu J, Shen L, Sun G. Squeeze-and-excitation ağları. In: 2018 IEEE/CVF Bilgisayar Görüntüsü ve Örüntü Tanıma Konferansı (CVPR) (Salt Lake City, UT: IEEE) (2018), 7132–41
-
38.
Krizhevsky A, Sutskever I, Hinton GE. Derin evrişimli sinir ağlarıyla ImageNet sınıflandırması. Commun ACM. (2017) 60(6):84–90. 10.1145/3065386
-
39.
Simonyan K, Zisserman A. Ölçekli görüntü tanıma için çok derin evrişimli ağlar. In: Temsil Öğrenimi Uluslararası Konferansı (ICLR) (2015).
-
40.
Szegedy C, Liu W, Jia Y, Sermanet P, Reed S, Anguelov D, et al. Evrişimlerle daha derine gitmek. In: 2015 IEEE Bilgisayar Görüntüsü ve Örüntü Tanıma Konferansı (CVPR) (Boston, MA: IEEE) (2015), 1–9
-
41.
He K, Zhang X, Ren S, Sun J. Deep residual learning for image recognition. In: 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR) (Las Vegas, NV: IEEE) (2016), 770–8
-
42.
Huang G, Liu Z, Van Der Maaten L, Weinberger K Q. Densely connected convolutional networks. In: 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR) (Honolulu, HI: IEEE) (2017), 2261–9
-
43.
Sandler M, Howard A, Zhu M, Zhmoginov A, Chen L C. Mobilenetv2: inverted residuals and linear bottlenecks. In: 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) (Salt Lake City, UT: IEEE) (2018), 4510–20
-
44.
Ma N, Zhang X, Zheng H, Sun J. Shufflenet V2: practical guidelines for efficient CNN architecture design. In: Ferrari V, Hebert M, Sminchisescu C, Weiss Y, editors. Computer Vision – ECCV 2018. Lecture Notes in Computer Science, vol. 11218. Cham: Springer (2018). p. 122–38.
-
45.
Deng J, Dong W, Socher R, Li L J, Li K, Fei-Fei L. Imagenet: a large-scale hierarchical image database. In: 2009 IEEE Conference on Computer Vision and Pattern Recognition. Miami, FL: IEEE (2009). p. 248–55.
-
46.
Micikevicius P, Narang S, Alben J, Diamos G, Elsen E, Garcia D, et al. Mixed precision training. In: International Conference on Learning Representations (ICLR) (2018).
-
47.
Kingma D P, Ba J. Adam: a method for stochastic optimization. In: International Conference on Learning Representations (ICLR) (2015).
-
48.
Lin T, Goyal P, Girshick R, He K, Dollar P. Focal loss for dense object detection. In: 2017 IEEE International Conference on Computer Vision (ICCV) (Venice: IEEE) (2017), 2999–3007
-
49.
Paszke A, Gross S, Massa F, Lerer A, Radbury J, Chanan G, et al. Pytorch: an imperative style, high-performance deep learning library. In: Advances in Neural Information Processing Systems 32 (NeurIPS) (2019), 8024–35
-
50.
Tejani A, Klontzas M, Gatti A, Amonan J, Moy L, Park S, et al. Checklist for artificial intelligence in medical imaging (CLAIM): 2024 update. Radiol Artif Intell. (2024) 6(4):e240300. 10.1148/ryai.240300
-
51.
Christiansen F, Konuk E, Ganeshan A, Welch R, Palés Huix J, Czekierdowski A, et al. International multicenter validation of AI-driven ultrasound detection of ovarian cancer. Nat Med. (2025) 31(1):189–96. 10.1038/s41591-024-03329-4
-
52.
Garcia-Atutxa I, Martínez-Más J, Bueno-Crespo A, Villanueva-Flores F. Early-fusion hybrid CNN-transformer models for multiclass ovarian tumor ultrasound classification. Front Artif Intell. (2025) 8:1679310. 10.3389/frai.2025.1679310
-
53.
Garcia-Atutxa I, Villanueva-Flores F, Dudagotia Barrio E, Sanchez-Villamil J, Martínez-Más J, Bueno-Crespo A. Artificial intelligence for ovarian cancer diagnosis via ultrasound: a systematic review and quantitative assessment of model performance. Front Artif Intell. (2025) 8:1649746. 10.3389/frai.2025.1649746
Summary
Keywords
data sızıntısı, derin öğrenme, açıklanabilir yapay zeka, federatif öğrenme, Grad-CAM, polikistik over sendromu, kısa yol öğrenme, ultrasonografy
Atıf
Priyanka D ve Sumangali K (2026) FedPCOS-XAI: ultrasonografik görüntülerden polikistik over sendromu sınıflandırması için güvenilirlik denetimli federatif öğrenme çerçevesi. Front. Digit. Health 8:1980374. doi: 10.3389/fdgth.2026.1980374
Müracaat tarihi
27 Ağustos 2026
Düzeltme tarihi
29 Eylül 2026
Kabul tarihi
05 Ekim 2026
Yayınlanma tarihi
12 Kasım 2026
Cilt
8 – 2026
Xiaofeng Li, Heilongjiang International University, Çin
Francisca Villanueva-Flores, National Polytechnic Institute (IPN), Meksika
Igor Garcia-Atutxa, Catholic University San Antonio of Murcia, İspanya
Kavita Shelke, Fr. C. Rodrigues Institute of Technology, Hindistan
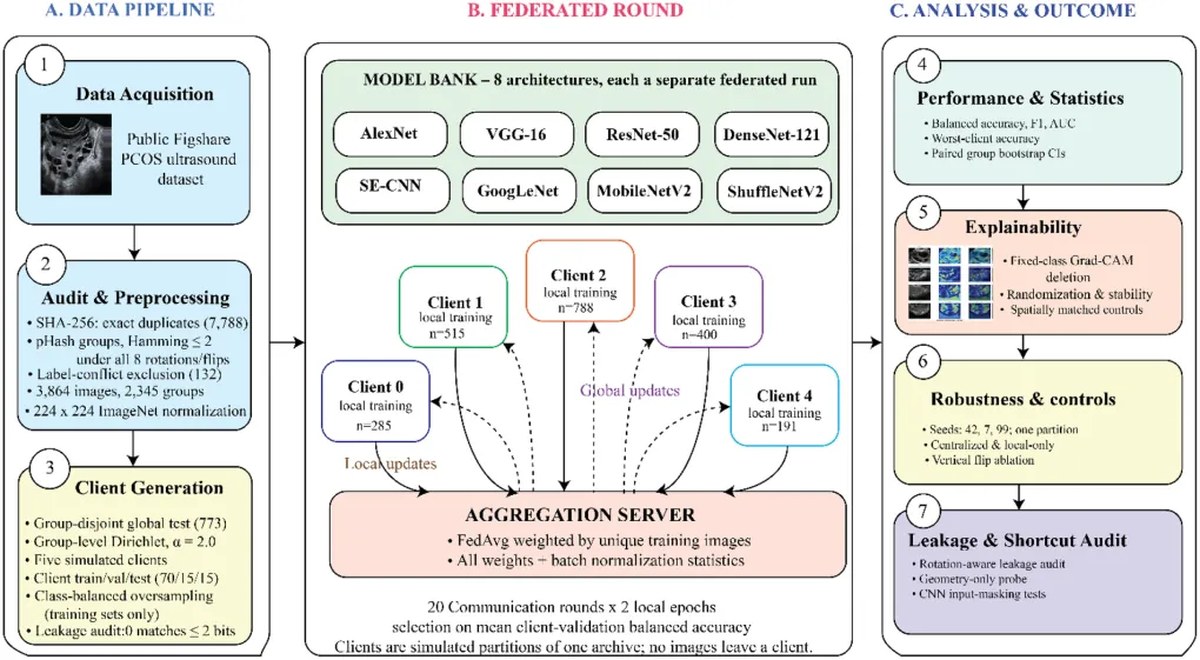
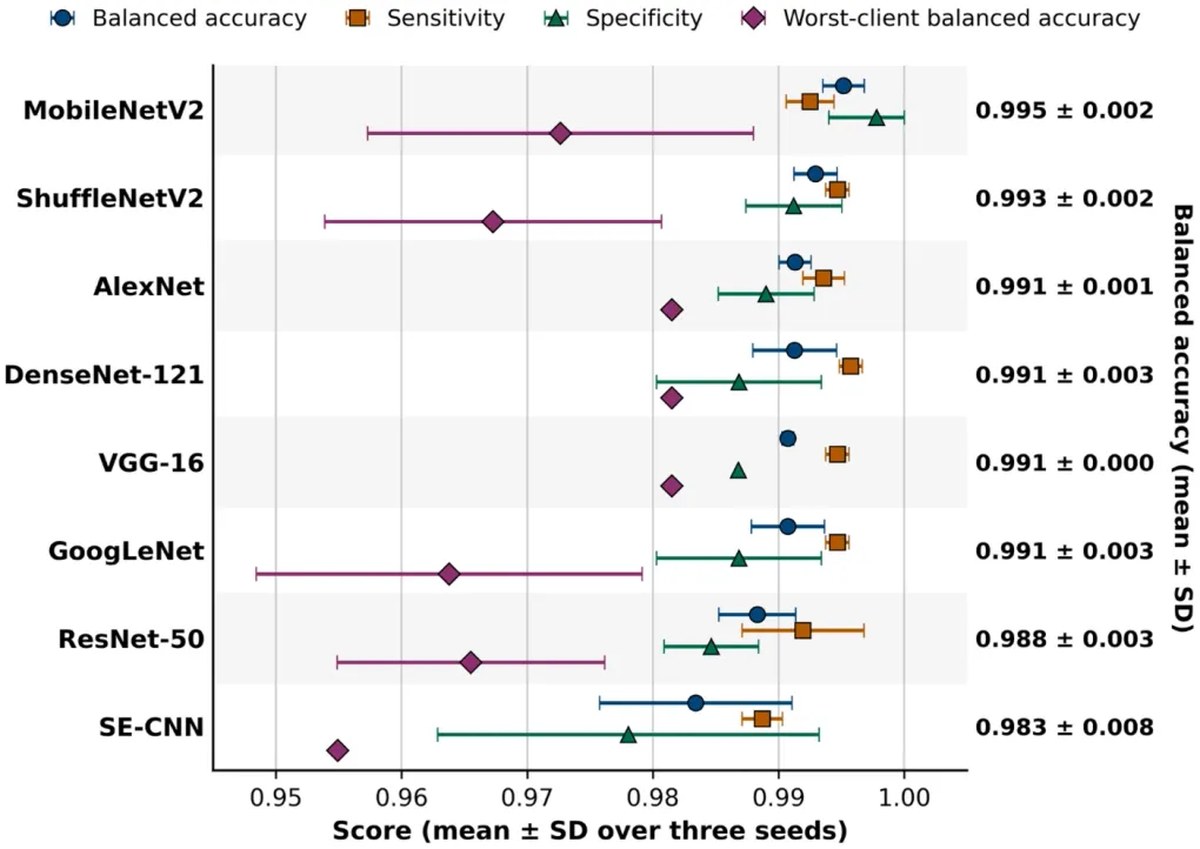
© 2026 Priyanka ve Sumangali.
Bu, Creative Commons Atıf Lisansı (CC BY) koşulları altında dağıtılan açık erişimli bir makaledir. Orijinal yazar(lar)ın ve telif hakkı sahib(lar)ının belirtilmesi ve kabul edilen akademik uygulamalar doğrultusunda bu dergideki orijinal yayının atıf edilmesi şartıyla, diğer platformlarda kullanım, dağıtım veya çoğaltma izinlidir. Bu koşullara uymayan hiçbir kullanım, dağıtım veya çoğaltma izinlidir.
*İletişim: K. Sumangali ksumangali@vit.ac.in
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, ya da yayıncının, editörlerin ve değerlendirenlerin görüşlerini kesin olarak yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.