Özet
Giriş:
Diabetes mellitus, dünya çapında yaygın görülen kronik bir metabolik bozukluktur ve erken tespiti, geri döndürülemez organ hasarını önlemek için kritik öneme sahiptir. Makine öğrenmesi (ML) yaklaşımları otomatik diyabet taramasında umut verici sonuçlar gösterse de, bu alan metodolojik eksikliklerden —özellikle ön işleme sırasında veri sızıntısı ve çapraz doğrulama katmanlarının dışında gerçekleştirilen aşırı örnekleme seçimi— olumsuz etkilenmektedir. Bu sorunlar bir araya gelerek aşırı iyimser ve klinik açıdan güvenilmez performans tahminlerine yol açmaktadır.
Yöntemler:
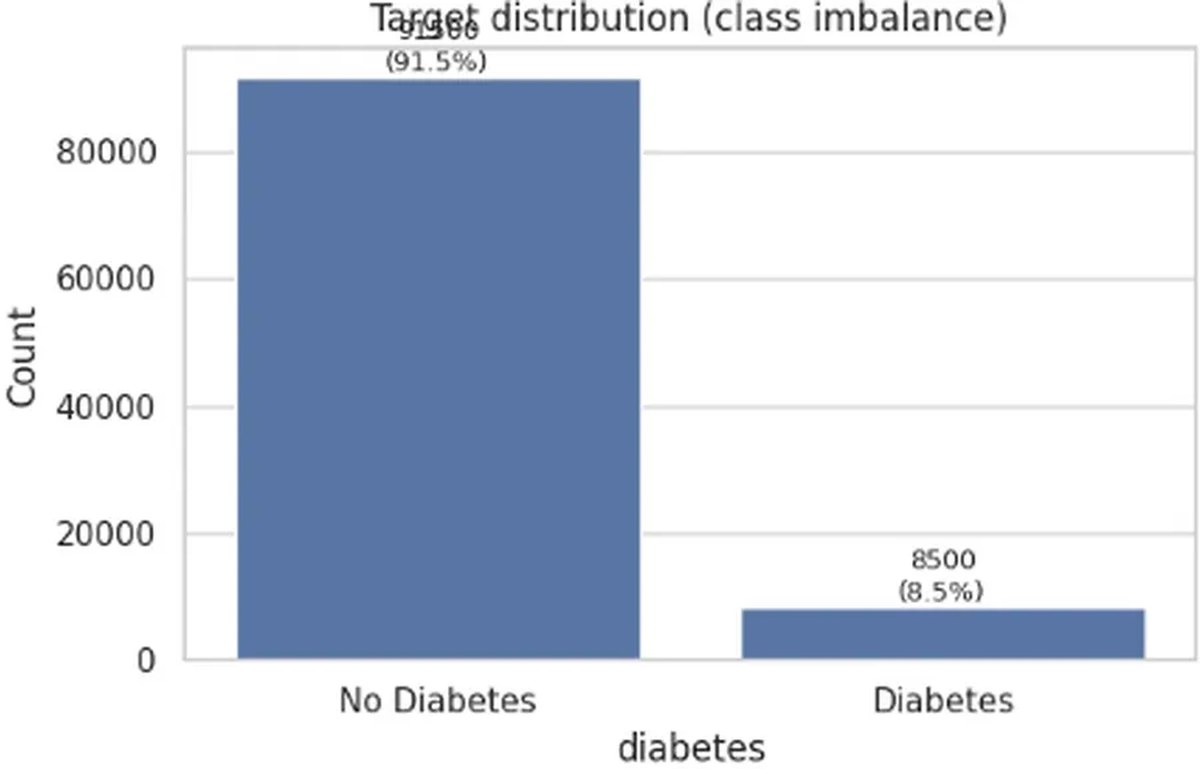
Bu çalışmada, 100.000 kayıt ve 15 özellik (yaygınlık oranı %8,5) içeren, halka açık büyük ölçekli sentetik bir klinik veri seti üzerinde değerlendirilen, sızıntıdan titizlikle korunmuş çok aşamalı bir ML boru hattı sunulmaktadır. Boru hattı iki tür sızıntıyı açıkça ele almaktadır: (i) ön işleme sızıntısı, tüm dönüştürücülerin yalnızca eğitim verileri üzerinde uyarlanmasıyla; ve (ii) yeniden örnekleme sızıntısı, aşırı örnekleme stratejilerinin karşılaştırmasının tamamen çapraz doğrulama katmanları içinde yapılmasıyla. Boru hattı şu adımları içermektedir: (i) eğitim, kalibrasyon ve ayrılmış test bölümleri için katmanlı üç yönlü bölme; (ii) yedi yeniden örnekleme stratejisinin, yeniden örnekleme yapılmayan sınıf ağırlıklı bir temel modelle çapraz doğrulama içinde karşılaştırılması ve SMOTETomek’in çapraz doğrulanmış F1 metriğine göre otomatik olarak seçilmesi; (iii) dört temel sınıflandırıcının (Lojistik Regresyon, Rastgele Orman, HistGradientBoosting, LightGBM) eğitilmesi; (iv) altı model birleştirme stratejisi; (v) izotonik olasılık kalibrasyonu; (vi) karar eğrisi analizi; ve (vii) Mondrian sınıf koşullu bölme-konformal tahmin.
Sonuçlar:
Tüm modeller arasında LightGBM, HistGradientBoosting ve logaritmik birleştirme topluluğu (Fus-LogPool) istatistiksel olarak eşdeğer en yüksek performansı elde etmiştir: PR-AUC değerleri sırasıyla 0,8807 (Fus-LogPool), 0,8801 (LightGBM) ve 0,8798 (HistGB) olup, çiftli McNemar testleri tutarlı bir şekilde anlamlı olmamıştır (p > 0,5). Bu durum, iyi ayarlanmış tek bir gradyan artırılmış ağacın bu veri setinde model birleştirmesi kadar etkili olduğunu göstermektedir. Mondrian konformal tahmini %90,39’luk ampirik kapsama oranına (hedef %90) ulaşmış, %98,82’si tekil tahminler olup tekil tahmin doğruluğu %91,46’dır. Karar eğrisi analizi, klinik olarak ilgili risk eşiklerinde (%5–%20) “hepsini tedavi etme” ve “hiçbiri tedavi etme” stratejilerine kıyasla net klinik fayda olduğunu doğrulamıştır. SHAP küresel açıklamaları HbA1c seviyesi, kan şekeri seviyesi, VKİ ve yaşın başlıca risk belirleyicileri olduğunu ortaya koymuştur.
Tartışma:
Önemli bir nokta olarak, tüm bulgular doğrulanmış bir klinik kaynağı olmayan sentetik veya yarı sentetik bir veri setinden elde edilmiştir ve herhangi bir klinik uygulamadan önce prospektif gerçek dünya kohortlarında doğrulanmalıdır. Tamamen tekrarlanabilir boru hattı, açık kaynaklı bir Kaggle defteri olarak yayınlanmıştır.
1 Giriş
Diabetes mellitus (DM), dünya çapında 537 milyondan fazla yetişkini etkilemekte ve 2045 yılına kadar bu sayının 783 milyonu aşması beklenmektedir; bu da küresel sağlık sistemleri üzerinde devasa bir yük oluşturmaktadır (). Tip 2 diyabetin sinsi doğası —genellikle ileri komplikasyonlar ortaya çıkana kadar semptomsuz olması— nüfus düzeyinde erken taramayı epidemiyolojik bir zorunluluk haline getirmektedir. Finnish Diabetes Risk Score (FINDRISC) ve American Diabetes Association (ADA) risk hesaplayıcısı gibi geleneksel risk sınıflandırma araçları yorumlanabilir olsalar da, elektronik sağlık kayıtlarında (EHR’ler) mevcut olan çok değişkenli etkileşim yapısından yararlanmamakta ve öz bildirim temelli subjektif girdilere dayanmaktadır.
Büyük EHR veri setleri üzerinde eğitilen makine öğrenmesi (ML) modelleri, geleneksel tarama araçlarını desteklemede veya onların yerini almada önemli potansiyel göstermiştir (–). Özellikle gradyan artırılmış ağaç modelleri (, ), çeşitli diyabet tahmin benchmark’larında 0,92–0,98 aralığında ROC-AUC değerleri sergilemiştir (–). Ancak, yayınlarda üç yaygın metodolojik eksiklik görülmektedir. Birincisi, ön işleme sızıntısı: tüm veri seti üzerinde uyarlanan imputasyon, ölçeklendirme ve kodlama işlemlerinin bölmeden önce uygulanması, test seti bilgilerinin eğitime sızmasına neden olarak sistematik olarak şişirilmiş performans tahminleri yaratmaktadır (). İkincisi, yeniden örnekleme sızıntısı: aşırı örnekleme teknikleri (örneğin SMOTE), tüm eğitim seti üzerinde uyarlanarak değerlendirilmektedir; bu da, bu teknikleri seçmek için kullanılan çapraz doğrulama sürecinin, aslında değerlendirmesi gereken sentetik örneklerle kirlenmesi anlamına gelmektedir (). Üçüncüsü, belirsizlik ölçümü olmaksızın nokta tahminiyle değerlendirme: modeller tek bir bölme metriğine göre sıralanmakta ve dağıtım olasılıkları, formel kalibrasyon kontrolleri (, ) veya kapsama garantileri olmadan olduğu gibi kabul edilmektedir ().
Bu çalışma, ilk iki sızıntı türünü kapsamlı bir boru hattı aracılığıyla doğrudan ele almaktadır.
terimini kullanmamızın nedeni, kapsamımızın kesin olarak tanımlanmış olmasıdır: ön işleme ve yeniden örnekleme sızıntısını ortadan kaldırırken, diğer sızıntı türlerinin (zamanlama, etiket ve özellik oluşturma sızıntısı) bu çalışmanın kapsamı dışında olduğunu açıkça belirtiyoruz. Spesifik katkılarımız şunlardır:
Ön işleme sızıntısını açıkça önleyen, tüm ön işleme dönüştürücülerinin yalnızca eğitim verileri üzerinde uyarlanıp kalibrasyon ve test setlerine salt okunur dönüşümler olarak uygulandığı katmanlı üç yönlü bir bölme (eğitim/kalibrasyon/test).
Yeniden örnekleme sızıntısını açıkça önleyen, yedi SMOTE ailesinden yeniden örnekleme stratejisinin, sınıf ağırlıklı yeniden örnekleme yapılmayan bir temel modelle çapraz doğrulama içinde adil bir şekilde karşılaştırılması ve stratejilerin veriye dayalı otomatik seçimi.
Dört temel sınıflandırıcının (Lojistik Regresyon, Rastgele Orman, HistGradientBoosting, LightGBM) eğitilmesi ve değerlendirilmesi, ardından ayrılmış test setinde değerlendirilen altı model birleştirme stratejisi ile birlikte McNemar testi aracılığıyla formel istatistiksel karşılaştırmalar.
Klinik tahmin modelleri için en iyi uygulama önerilerine uygun olarak izotonik regresyonla olasılık kalibrasyonu, güvenilirlik eğrisi görselleştirmesi ve Brier skoru karşılaştırması ().
Çeşitli risk eşiklerinde net klinik faydayı ölçen Karar Eğrisi Analizi (DCA) ().
%90 hedef seviyesinde sonlu örneklem ve dağılımdan bağımsız kapsama garantileri sağlayan Mondrian sınıf koşullu bölme-konformal tahmin (, ).
Klinik paydaşlar için model şeffaflığı sağlayan SHAP (SHapley Additive exPlanations) küresel özellik önem analizi (, ).
Temel Bulgular ve Genel Değerlendirme
5 Sonuç
Diabetes mellitus taraması için, klinik ML literatüründeki en yaygın iki metodolojik eksiklik olan ön işleme ve yeniden örnekleme sızıntısını açıkça ele alan, sızıntıdan korunmuş kapsamlı bir makine öğrenmesi boru hattı sunduk. Sızıntıdan korunmuş terimi bilinçli olarak kullanılmıştır: boru hattı, kapsamındaki iki sızıntı türünü önlerken, zamanlama, etiket ve özellik oluşturma sızıntılarının bu çalışmanın dışında olduğunu ve gelecekte araştırılmaları gerektiğini açıkça belirtmektedir.
Temel istatistiksel bulgu, gradyan artırılmış ağaç modellerinin (LightGBM ve HistGB) ve çeşitli birleştirme stratejilerinin ayırt edici performans açısından istatistiksel olarak eşdeğer olmasıdır (çiftli McNemar p>0,5): en iyi birleştirme modeli ile en iyi tekil temel model arasındaki 0,0006’lık PR-AUC farkı istatistiksel anlamlılık eşiğinin oldukça altındadır. İzotonik olasılık kalibrasyonu, net klinik faydayı doğrulayan karar eğrisi analizi ve %90,39’luk ampirik kapsama oranına ulaşan Mondrian konformal tahmini (konservatif bir bölme-kalibrasyon duyarlılık analizi altında %90,21’de doğrulanmıştır) değerlendirmeyi tamamlamaktadır. SHAP açıklamaları bilinen diyabet risk faktörleriyle uyumludur; ancak bu örüntülerin, veri setinin sentetik kökeni bağlamında yorumlanması gerekmektedir.
Tüm bulgular, doğrulanmış bir klinik kaynağı olmayan sentetik veya yarı sentetik bir veri setinden elde edilmiştir. Bu boru hattı, herhangi bir klinik uygulamadan önce gerçek dünya, kurumsal olarak toplanmış klinik verilerde uygulanması ve yeniden değerlendirilmesi gereken metodolojik bir çerçevedir. Tamamen tekrarlanabilir boru hattı ve tüm artefaktlar, benimsenmeyi ve daha ileri metodolojik gelişmeleri kolaylaştırmak amacıyla açık kaynaklı bir Kaggle defteri olarak sunulmuştur.
Beyanlar
Generatif Yapay Zeka beyanı
Yazar(lar), bu makalenin oluşturulmasında Generatif Yapay Zeka kullanılmadığını beyan etmiştir.
Bu makaledeki şekillerle birlikte sunulan tüm alternatif metinler (alt metinler) Frontiers tarafından yapay zeka desteğiyle oluşturulmuştur ve doğruluğu sağlamak için makul çabalar gösterilmiş, mümkün olduğunda yazarlar tarafından da incelenmiştir. Herhangi bir sorun tespit ederseniz lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve yazarların bağlı olduğu kurumların, yayıncının, editörlerin veya hakemlerin görüşlerini yansıtmak zorunda değildir. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisi tarafından yapılabilecek herhangi bir iddia, yayıncı tarafından garanti edilmez veya onaylanmaz.
Özet
Anahtar kelimeler
kalibrasyon, konformal tahmin, karar eğrisi analizi, diabetes mellitus, açıklanabilir yapay zeka, dengesiz sınıflandırma, sızıntı önleme, makine öğrenmesi
Atıf
Abrar F, Samaddar D, Al-Bashayreh MG, Rahman MT, Sadia SA, Essadik I, Muniasamy A, Burkhonova Z ve Mochhoury L (2026) Popülasyon düzeyindeki sağlık göstergelerini kullanarak prediyabet ve diyabet risk katmanlaması için çok modelli XAI çerçevesi. Front. Med. 13:1986834. doi: 10.3389/fmed.2026.1986834
Alındı
02 Eylül 2026
Revize edildi
03 Ekim 2026
Kabul edildi
06 Ekim 2026
Yayınlandı
17 Kasım 2026
13 – 2026
Mustafa Kutlu, Sakarya Uygulamalı Bilimler Üniversitesi, Türkiye
P. B. V. Raja Rao, Shri Vishnu Mühendislik Koleji (Kadınlar), Hindistan
Ashwini Kumar Jha, Parul Üniversitesi, Hindistan
© 2026 Abrar, Samaddar, Al-Bashayreh, Rahman, Sadia, Essadik, Muniasamy, Burkhonova ve Mochhoury.
Bu, Creative Commons Atıf Lisansı (CC BY) şartları altında dağıtılan açık erişimli bir makaledir. Orijinal yazarların ve telif hakkı sahiplerinin belirtilmesi ve bu dergideki orijinal yayına kabul edilen akademik uygulamalara uygun olarak atıfta bulunulması koşuluyla, diğer platformlarda kullanılması, dağıtılması veya çoğaltılmasına izin verilir. Bu şartlara uymayan hiçbir kullanım, dağıtım veya çoğaltmaya izin verilmez.
*İletişim: Fahim Abrar ZelphaHaefs434730@hotmail.com
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve yazarların bağlı olduğu kurumların, yayıncının, editörlerin veya hakemlerin görüşlerini yansıtmak zorunda değildir. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisi tarafından yapılabilecek herhangi bir iddia, yayıncı tarafından garanti edilmez veya onaylanmaz.